
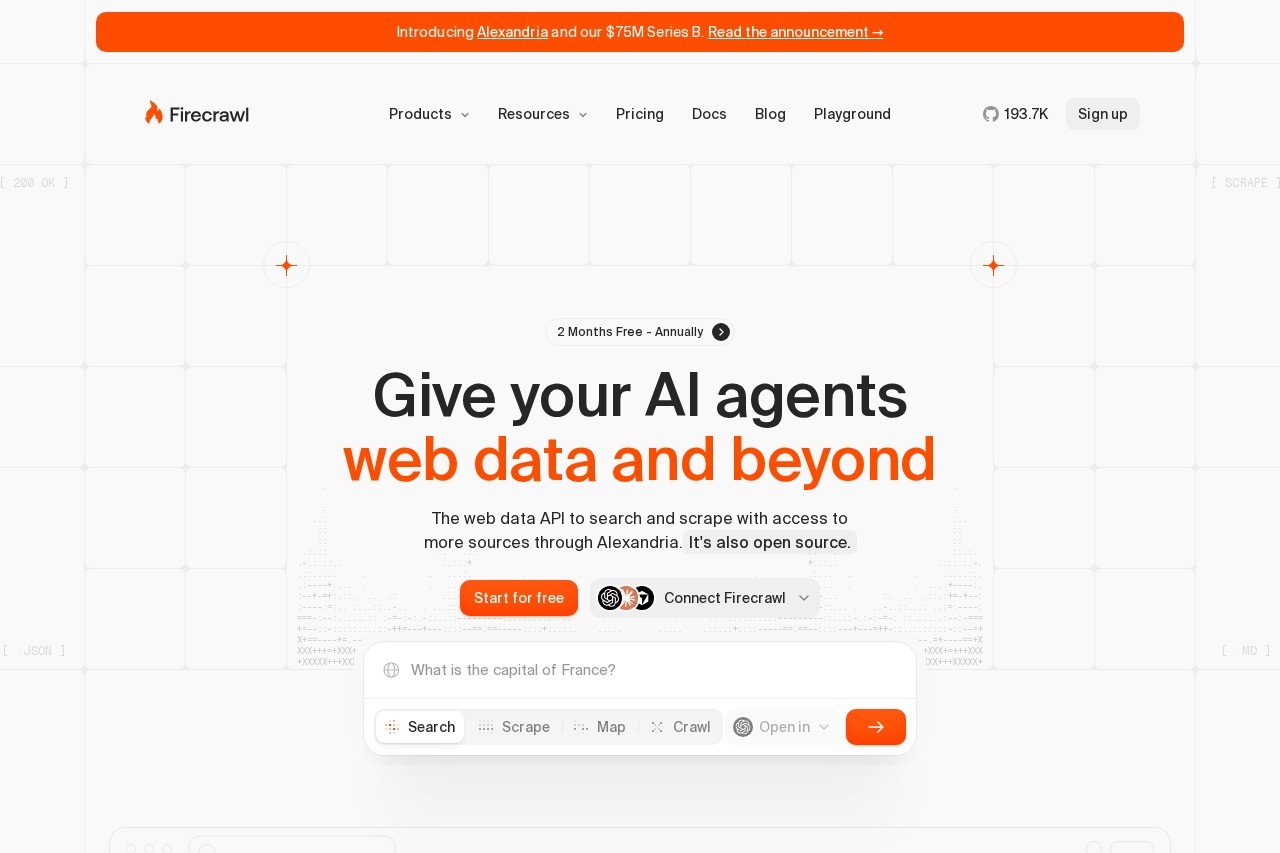
Firecrawl 是一个开源网页数据 API,让 AI agent 能够搜索、抓取、爬取、映射并操作实时网页,返回可直接供 LLM 使用的干净 Markdown 或 JSON,适合 AI 应用与数据工程团队。
简介
Firecrawl 是一个面向 AI agent 与 LLM 应用的网页数据 API。它针对 AI 开发中常见的瓶颈:语言模型需要干净、及时的网页内容,而原始 HTML 噪音多、token 消耗大,难以直接使用。Firecrawl 负责抓取、渲染与清理,开发者拿到的就是无需额外处理即可喂给模型的 Markdown 或结构化 JSON。
整套服务通过一个 API 家族覆盖完整工作流:用 Search 查找信息,用 Scrape 提取页面,用 Crawl 遍历整站,用 Map 探索站点结构,用 Parse 解析文档,用 Interact 驱动真实浏览器,用 Monitor 追踪变化。它是托管服务,无需本地浏览器环境,核心代码在 GitHub 上开源,已获得约 194,000 颗星。公司还提供 Firecrawl Alexandria,一个叠加在实时网页访问之上的授权内容源。
主要功能
定价与费用
- 定价:免费档每月提供 1,000 credits,无需绑卡。付费方案按年计费:Hobby $16/月(5,000 credits)、Standard $83/月(100,000 credits)、Growth $333/月(500,000 credits)、Scale $599/月(1,000,000 credits);Enterprise 定制报价。价格为美元,截至 2026 年 9 月 4 日。
- Credit 体系:基本 scrape、crawl 或 map 每页消耗 1 credit;search 每 10 条结果消耗 2 credits;Interact 每浏览器分钟消耗 2 credits。
- 性能数据:官方在其自建的 1,000-URL 基准测试(2026 年 1 月 13 日运行)中报告覆盖率 96%,Puppeteer 为 79%,cURL 为 75%;P95 延迟 3,387 ms,输入 token 相比原始页面减少约 93%。
- 开源:代码在 GitHub 上公开,支持自行部署。
- 空结果不收费:无返回结果的 scrape 不计费,但 404 等错误状态页面仍消耗 1 credit。
适用人群
Firecrawl 面向需要实时网页上下文的 AI agent、聊天机器人和研究工具开发者。典型用户包括为助手接入检索的 AI 应用工程师、搭建爬取管线的数据团队,以及使用 Claude Code、Cursor 等编程 agent、希望免写爬虫代码即可获得网页访问能力的开发者。它也适合需要文档解析、定时页面监控,或通过 Alexandria 获取授权内容用于研究与知识应用的产品团队。
常见问题
Firecrawl 是什么?它是一个开源网页数据 API,让 AI 应用能够搜索、抓取、爬取、映射、解析并与网页交互,返回为语言模型优化的干净 Markdown 或 JSON。
有免费方案吗?有。免费档每月提供 1,000 credits(约合 500 次搜索或 1,000 个抓取页面),支持两个并发请求,无需信用卡。
支持哪些平台和集成?提供 Python、Node.js、Go 官方 SDK、CLI、面向 Claude、Cursor、VS Code 等客户端的 MCP 服务器及预构建 agent 技能;Scale 和 Enterprise 方案也可通过 AWS 与 Google Cloud 市场购买。
与直接使用 Puppeteer 或 cURL 相比如何?在 Firecrawl 自建的 1,000-URL 基准测试中,其成功覆盖率为 96%,Puppeteer 为 79%,cURL 为 75%,同时自动处理 JavaScript 渲染、智能等待和内容清理。
可以自行部署吗?可以。代码在 GitHub 上开源,团队可审查、贡献或自行运行;Enterprise 方案还提供零数据保留、SSO 等选项。
相关教程
查看全部 →

相关工具
查看全部 → TinyFish TinyFish 是面向 AI agent 的网络基础设施,把实时网页搜索、页面抓取、云端浏览器会话和多步骤自动化整合到一个 API 之后,适合需要真实网络访问的开发者和自动化团队。
 OmniRoute — Free AI Gateway for Multi-Provider LLMs Free, open-source AI router with auto-fallback. 236 providers, one endpoint, 95 MCP tools, 17 routing strategies, A2A protocol, auto-combo engine, semantic cache, memory & skills. Deploy anywhere.
 OpenHands Open-source, model-agnostic platform for building and deploying cloud coding agents. Automate real engineering work securely with full transparency and control.
 Agent-Native — Agent-Native Apps Framework Build agentic apps where AI agents and UI share the same database and state. Open source framework with ready-to-fork templates.
 DeerFlow - 超级智能体框架 A LangChain-based framework for building super agents.