Introdução
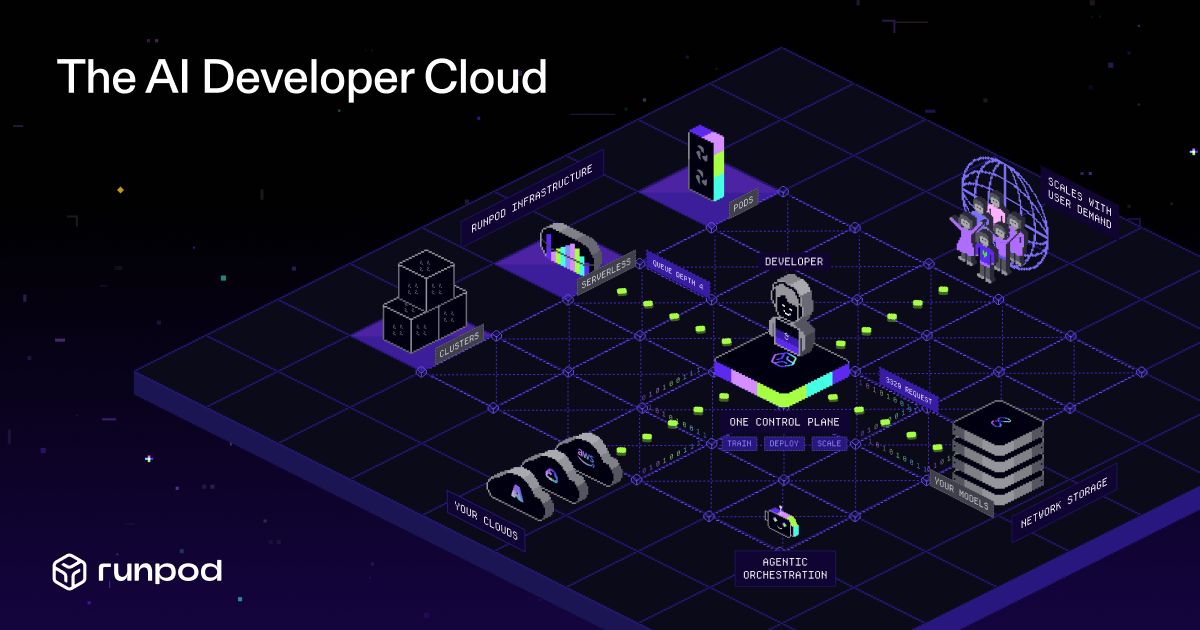
Runpod, com a marca "The AI Developer Cloud", fornece computação em GPU para equipes que precisam experimentar, treinar, fazer fine-tuning, implantar e escalar cargas de trabalho de IA em uma única plataforma. O serviço resolve uma frustração comum para desenvolvedores de IA: migrar entre provedores diferentes conforme um projeto cresce de protótipo para produção exige trabalho de migração que atrasa as equipes.
O Runpod funciona por meio de três produtos principais. Pods são instâncias de GPU dedicadas sob demanda, disponíveis em 31 regiões globais e com mais de 30 SKUs de GPU, variando de RTX 4090s a B200s. O Serverless executa cargas de trabalho de inferência em contêineres atrás de uma API, com workers que escalam automaticamente de zero a milhares conforme a demanda e não custam nada enquanto ociosos. Os Clusters suportam ambientes de GPU multi-nó para treinamento distribuído e jobs em lote de grande porte. Tudo funciona em uma única conta, e o Runpod também fornece uma CLI, uma API REST, SDKs e endpoints MCP hospedados para gerenciar cargas de trabalho programaticamente. A empresa afirma que mais de um milhão de desenvolvedores usam a plataforma.
Principais Recursos
- GPU Pods: Instâncias de GPU dedicadas que podem ser iniciadas em menos de um minuto, com mais de 30 SKUs de GPU que vão de placas de consumo a GPUs de data center como a B300 e H200.
- Endpoints serverless: Cargas de trabalho de inferência em contêineres servidas atrás de uma API, com escalonamento automático de zero a milhares de workers e sem cobranças ociosas quando um endpoint não está em execução.
- Cold starts rápidos: Um recurso chamado FlashBoot reduz o tempo de cold-start para menos de 200 milissegundos, diminuindo a necessidade de manter workers aquecidos em execução.
- Clusters multi-nó: Capacidade de GPU coordenada para treinamento distribuído e cargas de trabalho em lote intensivas em computação.
- Implantação global: As cargas de trabalho podem ser executadas em 31 regiões ao redor do mundo, com a opção de implantar modelos e templates open-source por meio do Runpod Hub.
- Ferramentas para desenvolvedores: Uma CLI (runpodctl), API REST, SDKs, logs em tempo real, monitoramento e métricas, além de servidores MCP e agent skills para ferramentas como Claude Code, Codex e Cursor.
- Armazenamento de rede persistente: Armazenamento de rede que suporta pipelines completos de IA sem taxas de egress.
Destaques
- Preços: Os pods de GPU são cobrados por hora e por segundo, com tarifas divulgadas incluindo US$ 8,99/hora para a B300, US$ 5,29/hora para a H200, US$ 3,99/hora para a H100 SXM, US$ 2,89/hora para a H100 PCIe, US$ 1,79/hora para a A100, US$ 1,19/hora para a RTX 5090 e US$ 0,59/hora para placas como a A40 e L4. Capacidade reservada e preços por contrato estão disponíveis por meio de vendas corporativas.
- Plano gratuito: A página inicial anuncia uma opção de "começar de graça", para que novos usuários possam criar uma conta antes de se comprometer com computação paga.
- Confiabilidade: O Runpod cita uma meta de 99,9% de uptime e afirma que gerencia failovers para que as cargas de trabalho continuem quando os recursos subjacentes falham.
- Escala: A plataforma suporta escalonamento para milhares de GPUs e cita um exemplo de cliente que processa mais de 1.000 requisições de inferência por segundo.
Para Quem É
O Runpod foi criado para desenvolvedores de IA e engenheiros de machine learning que precisam de computação em GPU flexível sem gerenciar hardware físico. Os usuários típicos incluem equipes que fazem fine-tuning ou treinamento de modelos, desenvolvedores que servem APIs de inferência em tempo real com tráfego imprevisível, pesquisadores que executam experimentos intensivos em computação e empresas que implantam agentes de IA que precisam reagir e escalar sob demanda. Também atende empresas que precisam de capacidade reservada, revisões de segurança e suporte a procurement. Desenvolvedores que desejam implantar modelos open-source rapidamente, como LLMs hospedados com vLLM, encontrarão templates prontos no Runpod Hub.