
Runpod 是面向 AI 开发者的 GPU 云平台,提供按需 GPU Pods、Serverless AI 推理端点和多节点集群,适合需要训练与部署 AI 工作负载的团队使用。
简介
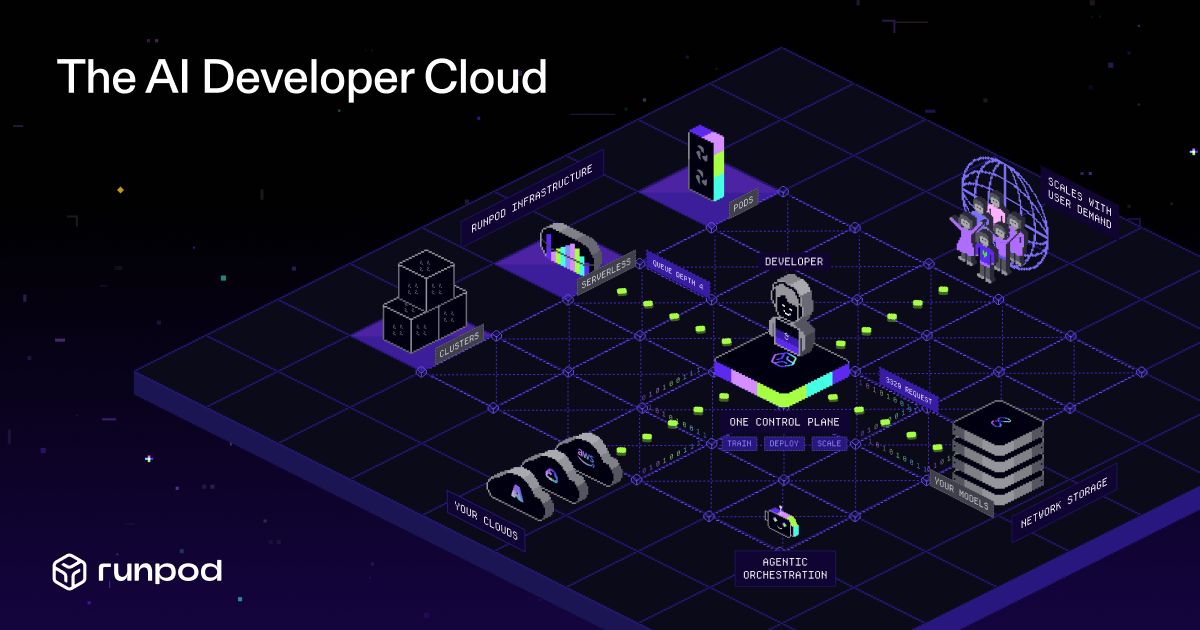
Runpod 以 "The AI Developer Cloud" 为定位,为需要在同一平台上实验、训练、微调、部署和扩展 AI 工作负载的团队提供 GPU 算力。它针对 AI 开发者常见的一个痛点:项目从原型走向生产的过程中,往往要在不同服务商之间迁移,拖慢团队进度。
Runpod 由三个主要产品构成。Pods 是专用的按需 GPU 实例,覆盖全球 31 个区域,提供从 RTX 4090 到 B200 的 30 多种 GPU SKU。Serverless 通过 API 承载容器化推理工作负载,worker 可根据需求从零自动扩展到数千个,闲置时不产生费用。Clusters 支持多节点 GPU 环境,用于分布式训练和大规模批处理任务。所有资源都在同一个账户下运行,Runpod 还提供 CLI、REST API、SDK 以及托管的 MCP 端点,方便以编程方式管理工作负载。公司称平台上已有超过 100 万名开发者。
主要功能
定价与费用
- 定价:GPU Pods 按小时和按秒计费,标注费率包括 B300 $8.99/小时、H200 $5.29/小时、H100 SXM $3.99/小时、H100 PCIe $2.89/小时、A100 $1.79/小时、RTX 5090 $1.19/小时,以及 A40、L4 等显卡 $0.59/小时。预留容量和合约价格可通过企业销售渠道获取。
- 免费入门:官网首页提供 "get started for free" 选项,新用户可先注册账户,再决定是否购买付费算力。
- 可靠性:Runpod 给出的正常运行时间目标为 99.9%,并称具备故障转移处理能力,底层资源故障时工作负载可继续运行。
- 规模:平台支持扩展到数千块 GPU,并援引了一个客户每秒处理超过 1,000 次推理请求的案例。
适用人群
Runpod 面向需要灵活 GPU 算力又不想自行管理物理硬件的 AI 开发者和机器学习工程师。典型用户包括微调或训练模型的团队、为流量不稳定的实时推理 API 提供服务的开发者、运行计算密集型实验的研究人员,以及部署需要按需响应和扩展的 AI agent 的企业。它也服务于需要预留容量、安全审查和采购支持的企业客户。希望快速部署开源模型(如 vLLM 托管的 LLM)的开发者,可以在 Runpod Hub 中找到现成模板。
常见问题
Runpod 是什么?Runpod 是一个 AI 开发者云,提供专用 GPU Pods、Serverless GPU 推理端点和多节点 GPU 集群,用于构建、部署和扩展 AI 工作负载。
Runpod 的价格是多少?Pod 采用按量计费,按小时或按秒列出费率,例如 H200 为 $5.29/小时、A100(80 GB)为 $1.79/小时。Serverless 端点闲置时免费,预留容量通过企业销售渠道报价。
Runpod 有免费计划吗?官网首页提供免费入门方式,但持续的 GPU 使用会按实际消耗的算力计费;最新详情请查看官方定价页面。
Runpod 支持与哪些平台和工具集成?Runpod 提供 CLI、REST API、Python SDK、托管 MCP 服务器,以及面向 Claude Code、Codex、Cursor 等编程工具的 agent skills,其 Hub 还提供可部署的开源模型模板。
Runpod 如何保障可靠性与安全性?Runpod 宣称 99.9% 的正常运行时间目标、自动故障转移处理、默认安全的配置,并设有合规页面和安全资料供评估平台的团队查阅。
相关教程
查看全部 →
相关工具
查看全部 → LangChain LangChain provides a comprehensive suite of products to support developers throughout their entire development workflow.
 Llama Llama 4提供高性能、多模态、低成本的领先AI模型Scout和Maverick。
 OpenRouter OpenRouter 是一个统一的、兼容 OpenAI 的 API,让开发者按用量付费调用来自 80+ 供应商的 500+ 个文本、图像、视频和音频 AI 模型。
 OmniRoute — Free AI Gateway for Multi-Provider LLMs Free, open-source AI router with auto-fallback. 236 providers, one endpoint, 95 MCP tools, 17 routing strategies, A2A protocol, auto-combo engine, semantic cache, memory & skills. Deploy anywhere.
 OpenHands Open-source, model-agnostic platform for building and deploying cloud coding agents. Automate real engineering work securely with full transparency and control.