Introdução
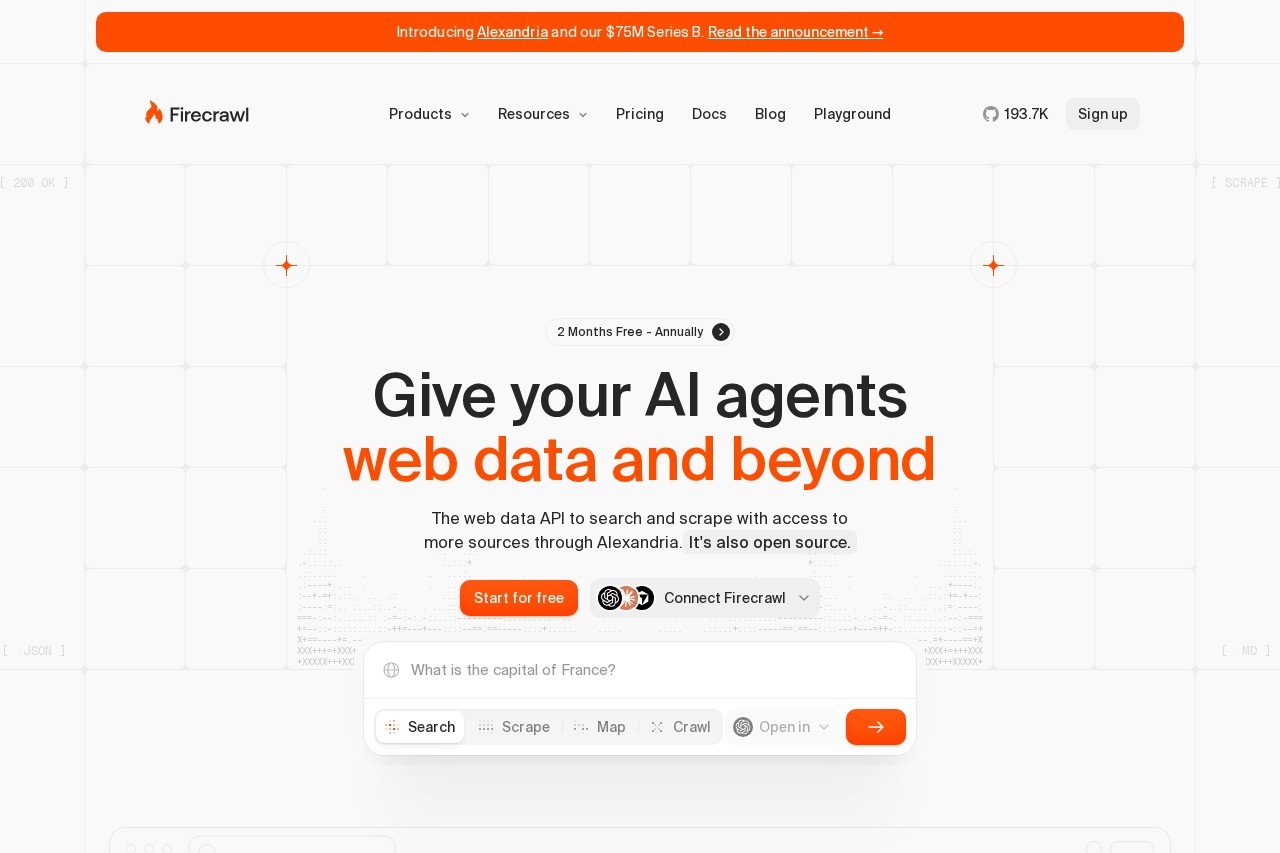
Firecrawl é uma API de dados web construída para agentes de IA e aplicações LLM. Ela resolve um gargalo comum no desenvolvimento de IA: modelos de linguagem precisam de conteúdo web limpo e atualizado, mas o HTML bruto é ruidoso, pesado em tokens e difícil de usar diretamente. O Firecrawl cuida da busca, renderização e limpeza para que os desenvolvedores recebam Markdown ou JSON estruturado que o modelo pode consumir sem processamento adicional.
O serviço cobre um fluxo de trabalho completo em uma única família de APIs: encontre informações com Search, extraia páginas com Scrape, percorra sites inteiros com Crawl, descubra a estrutura de sites com Map, analise documentos com Parse, controle navegadores reais com Interact e acompanhe mudanças com Monitor. É um serviço gerenciado que não exige configuração de navegador local, e o código-fonte principal é open source no GitHub, com cerca de 194.000 estrelas. A empresa também oferece o Firecrawl Alexandria, uma fonte de conteúdo licenciada adicionada ao acesso à web em tempo real.
Principais Recursos
- Search: Consulta a web em tempo real e retorna o conteúdo completo das páginas de resultados, em vez de apenas links ou trechos, para que os agentes obtenham contexto completo em uma única chamada.
- Scrape: Converte qualquer página, incluindo as renderizadas com JavaScript, em Markdown, JSON, HTML ou capturas de tela prontos para LLMs, com navegação, anúncios e elementos genéricos removidos.
- Crawl e Map: Percorre sites inteiros em profundidade com filtros, ou lista rapidamente todas as URLs de um site para descoberta estrutural.
- Interact: Executa automação de navegador em múltiplas etapas — clicar, digitar, rolar, fazer login — orientada por prompts de IA ou código, e retorna resultados como preços extraídos ou textos.
- Parse: Extrai conteúdo de PDFs, DOCX e formatos de documentos semelhantes, além de páginas web comuns.
- Monitor: Verifica páginas nomeadas, rastreamentos agendados ou buscas de forma recorrente e notifica via webhook, e-mail ou Slack quando algo muda.
- Integração com agentes: Conecta-se a agentes de IA por meio de SDKs oficiais para Python, Node.js, Go e outros, um servidor MCP para clientes como Claude e Cursor, uma CLI e skills pré-construídas — incluindo um tier gratuito sem chave para agentes.
Destaques
- Preços: O tier gratuito oferece 1.000 créditos por mês sem necessidade de cartão. Planos pagos, com cobrança anual: Hobby $16/mês (5.000 créditos), Standard $83/mês (100.000 créditos), Growth $333/mês (500.000 créditos) e Scale $599/mês (1.000.000 créditos); preços Enterprise sob consulta. Os preços são em USD e vigentes a partir de 4 de setembro de 2026.
- Sistema de créditos: Um crédito cobre uma página em um scrape, crawl ou map básico; a busca custa 2 créditos por 10 resultados; o Interact custa 2 créditos por minuto de navegador.
- Alegações de desempenho: O fornecedor relata 96% de cobertura em seu próprio benchmark de 1.000 URLs (executado em 13 de janeiro de 2026), contra 79% do Puppeteer e 75% do cURL, com latência P95 de 3.387 ms e cerca de 93% menos tokens de entrada em relação às páginas brutas.
- Open source: O código-fonte é público no GitHub e pode ser auto-hospedado.
- Sem cobrança por resultados vazios: Um scrape que não retorna resultado não é cobrado, embora páginas com status de erro, como 404, ainda custem um crédito.
Para Quem É
O Firecrawl é voltado para desenvolvedores que constroem agentes de IA, chatbots e ferramentas de pesquisa que precisam de contexto web em tempo real. Os usuários típicos incluem engenheiros de aplicações de IA integrando recuperação de dados em assistentes, equipes de dados construindo pipelines de rastreamento e criadores que usam agentes de código como Claude Code ou Cursor e querem acesso à web sem escrever código de scraping. Também atende equipes de produto que precisam de análise de documentos, monitoramento agendado de páginas ou acesso a conteúdo licenciado por meio do Alexandria para aplicações de pesquisa e conhecimento.