
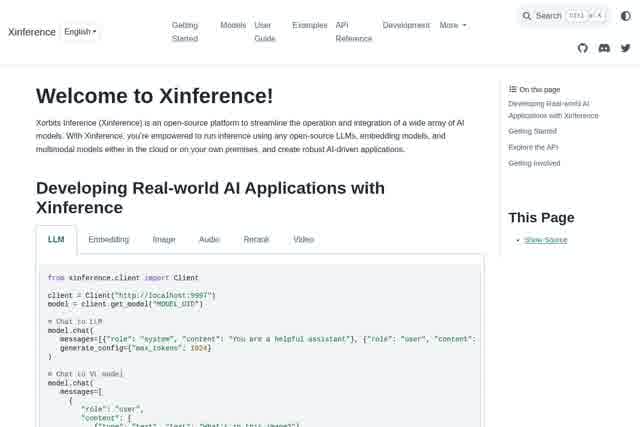
简介
Xinference 是一个功能强大的开源模型推理平台,旨在为用户提供高效、可扩展的模型服务解决方案。作为一个面向实际生产场景的推理平台,它致力于解决模型从训练完成到稳定对外服务这一过程中的各类难题,让推理服务不再是 AI 落地路上的瓶颈。
平台支持多种主流深度学习框架和灵活的部署环境,帮助开发者和企业轻松实现模型的部署、管理和优化。无论是构建原型验证想法,还是承载大规模线上流量,Xinference 都能满足不同场景下的推理需求,让团队将精力集中在模型本身而非基础设施上。
主要功能
支持多种框架:兼容 TensorFlow、PyTorch、ONNX 等主流深度学习框架,开发者无需为不同框架单独搭建推理环境,可以沿用现有的技术栈与模型资产,显著降低跨框架部署的技术门槛。
弹性扩展:可根据负载动态调整资源,在业务高峰期保障推理服务的响应能力,在负载回落时避免资源闲置浪费,从而实现高性能且经济高效的推理服务。
模型管理:提供模型版本控制、部署和监控功能,覆盖模型从上线到运行的全过程,方便团队追踪不同版本的模型状态,及时发现并处理线上问题,让模型运维有据可依。
多环境部署:支持本地、云端和边缘计算环境,无论是在本地开发调试、在云端承载核心业务,还是在边缘侧进行低延迟推理,都能灵活适配,满足多样化的部署需求。
适用人群
Xinference 非常适合机器学习工程师、数据科学家、DevOps 工程师以及需要大规模部署 AI 模型的企业团队。数据科学家和算法工程师可以借助它将训练好的模型快速转化为可用的推理服务,DevOps 工程师则能利用其模型管理与弹性扩展能力简化线上运维工作。
无论是学术研究中的原型验证,还是工业生产环境中对稳定性和性能有严格要求的业务系统,Xinference 都能提供稳定可靠的推理服务支持,是连接模型研发与实际应用之间的重要桥梁。
相关教程
查看全部 →


相关工具
查看全部 → DFlash: Block Diffusion for Flash Speculative Decoding - Z Lab 高效块扩散投机解码
 Rig - Build Powerful LLM Applications in Rust Rig: A Rust framework for building modular, scalable LLM applications. Features a unified LLM interface, Rust-native performance, and advanced AI workflow abstractions to streamline development.
 Supervision Supervision是Roboflow提供的计算机视觉工具库,用于模型推理、标注和可视化。
 TensorRT-LLM TensorRT-LLM 是 NVIDIA 推出的高性能深度学习推理库,专为大语言模型优化,提供详细的文档和开发指南。
 Dify.AI Dify.AI 是一个开源平台,用于构建 Agentic AI 工作流、RAG 知识管线和 LLM 应用,可部署在云端、VPC 或通过 Docker 自托管,适合开发团队与企业用户。