
TensorRT-LLM 是 NVIDIA 推出的高性能深度学习推理库,专为大语言模型优化,提供详细的文档和开发指南。
标签
最后更新 2026 年 11 月 10 日
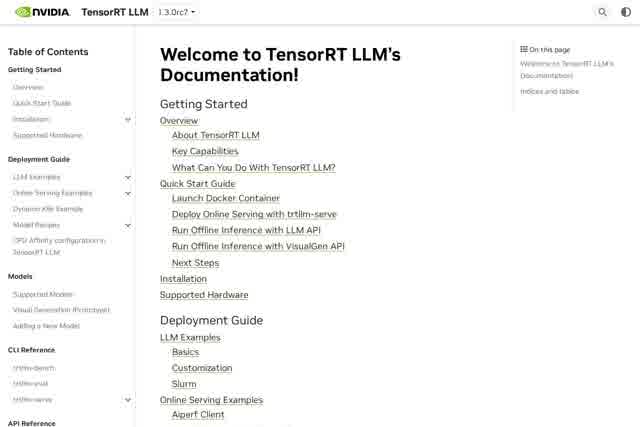
简介
TensorRT-LLM 是由 NVIDIA 推出的一款专为大语言模型(LLM)优化的高性能深度学习推理库。它基于 NVIDIA TensorRT 构建,继承了 TensorRT 在推理加速方面的深厚积累,并针对大语言模型的负载特点进行了专门设计。其核心目标是帮助开发者和企业高效部署和运行大规模语言模型,在显著提升推理速度的同时优化资源利用率,让相同的硬件能够承载更多推理请求。无论是用于自然语言处理、对话式 AI,还是内容生成等应用场景,TensorRT-LLM 都提供了强大的工具和全面的支持,是连接大语言模型与 NVIDIA GPU 算力之间的重要桥梁。
主要功能
高性能推理优化:通过内核融合(Kernel Fusion)合并计算操作以减少开销,结合量化技术降低计算与存储负担,并支持动态形状以灵活应对不同长度的输入输出,从而大幅提升模型推理速度。
多 GPU 扩展:当单个 GPU 难以承载超大模型时,支持跨多块 GPU 进行并行推理,将模型与计算任务合理拆分,轻松应对超大规模语言模型的部署需求。
框架兼容性:与 PyTorch、TensorFlow 等主流深度学习框架无缝集成,开发者可以在熟悉的工作流中直接引入 TensorRT-LLM 的加速能力,无需大幅改动现有流程。
详细文档和示例:提供内容丰富的开发指南、API 文档和代码示例,覆盖从入门到进阶的常见问题,有效降低学习与使用门槛,帮助团队更快落地。
定价与费用
- 定价:我们审阅的页面上未公开列出;请查看官方网站获取最新方案。
- 许可方式:TensorRT-LLM 是 NVIDIA 的开源库,附带公开文档,软件本身不按席位收费。
- 硬件要求:面向 NVIDIA GPU 硬件,部署指南覆盖 Blackwell 和 Hopper 等特定架构。
- 功能特性:支持多种推理优化特性,包括 in-flight batching、投机解码、KV cache 压缩与卸载以及 LoRA 适配器。
- 服务选项:提供兼容 OpenAI 的服务 API(trtllm-serve),并附带的基准测试与评估命令行工具。
适用人群
TensorRT-LLM 适用于多种场景和广泛的用户群体,包括:
- AI 研究人员:在模型实验与评估中获得更快的推理反馈,加速研究迭代。
- 机器学习工程师:借助其优化能力,将训练好的模型高效推向线上服务。
- DevOps 工程师:在部署与运维环节中,利用其资源利用率优势和稳定的推理表现,管理大规模模型服务。
- 企业技术决策者:可将其作为大模型落地的基础设施选型,兼顾性能与部署效率。
无论是希望加速模型推理、以有限资源支撑更多业务的初创公司,还是需要部署超大规模语言模型、服务大量用户的大型企业,都能从 TensorRT-LLM 中获得切实收益。
相关教程
查看全部 →


相关工具
查看全部 → DFlash: Block Diffusion for Flash Speculative Decoding - Z Lab 高效块扩散投机解码
 Rig - Build Powerful LLM Applications in Rust Rig: A Rust framework for building modular, scalable LLM applications. Features a unified LLM interface, Rust-native performance, and advanced AI workflow abstractions to streamline development.
 Supervision Supervision是Roboflow提供的计算机视觉工具库,用于模型推理、标注和可视化。
 Dify.AI Dify.AI 是一个开源平台,用于构建 Agentic AI 工作流、RAG 知识管线和 LLM 应用,可部署在云端、VPC 或通过 Docker 自托管,适合开发团队与企业用户。
 Flowise 开源生成式AI开发平台,支持可视化构建AI智能体和LLM编排。