
Serverless GPU inference cloud for open-source LLMs at affordable prices.
标签
最后更新 2026 年 11 月 10 日
简介
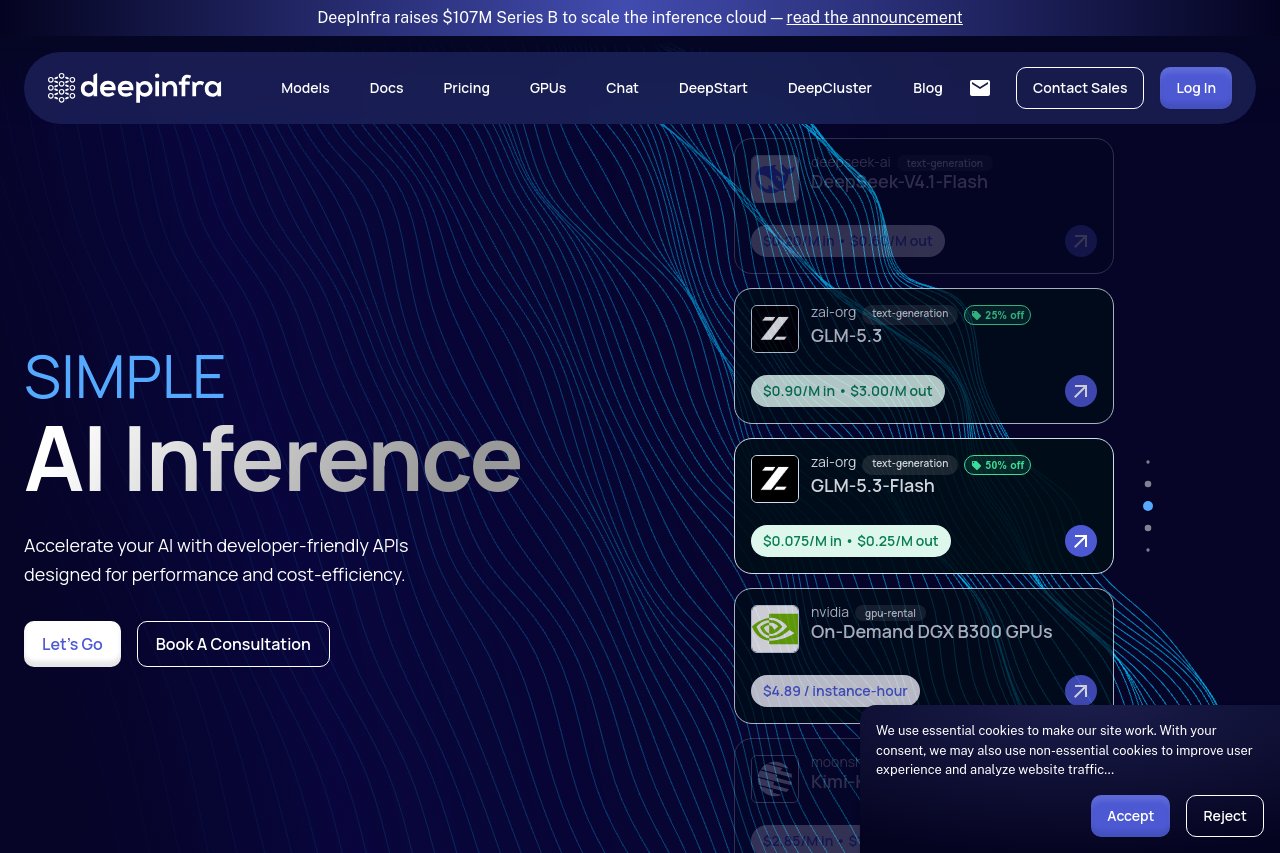
DeepInfra 是一个面向开源大语言模型的 Serverless GPU 推理云平台,致力于以亲民的价格提供生产级性能的模型推理服务。传统方式下,开发者若要部署开源模型,往往需要采购昂贵的 GPU 硬件、搭建并维护集群,承担持续的基础设施投入与运维负担;而 DeepInfra 将这些底层工作全部交由云端托管,开发者只需通过简单的 API 调用,即可在云端运行 Llama、Mistral、Qwen、DeepSeek 等主流开源模型,大幅降低 AI 应用的开发与运营门槛。对于没有专业基础设施团队的个人开发者或小型团队而言,这种“开箱即用”的模式意味着可以把更多精力集中在产品逻辑与用户体验本身,而不是算力管理上。
主要功能
丰富的开源模型库:覆盖文本生成、对话、Embedding、图像生成、语音识别等多种模型类型,无论是聊天问答、内容创作,还是语义检索、图像创作、语音转写等场景,都能找到对应的模型支持,且库中涵盖 Llama、Mistral、Qwen、DeepSeek 等主流开源模型。
兼容 OpenAI API 格式:接口规范与 OpenAI 保持一致,已基于 OpenAI 生态构建的应用,几乎无需修改现有代码即可平滑迁移,显著减少接入与改造的工作量。
灵活的部署模式:同时支持按量计费的 Serverless 部署与专属 GPU 实例两种模式——前者适合流量波动较大、希望只为实际用量付费的场景,后者适合对算力资源有稳定需求的长期负载。
自动弹性伸缩:平台根据请求流量的实时变化动态分配算力,无需人工预估容量或手动扩容,即使面对突发流量也能保持服务稳定运行。
模型微调与私有模型托管:支持对模型进行微调,使其更贴合特定业务需求,并提供私有模型托管能力,方便团队将定制化模型安全地部署到自己的工作流中。
定价与费用
- 定价:DeepInfra 采用按用量付费模式,无长期合同或前期费用。语言模型按 token 计费(例如 DeepSeek-V4-Flash 为 $0.09/百万输入 token、$0.18/百万输出 token;Kimi-K3 为 $2.85 / $14.25),其他多数模型按推理执行时间计费。
- Token 计费示例:主打模型 DeepSeek-V4-Flash-Vision-Exp 每 1M 输入 token 收费 $0.2156(缓存 $0.0069),每 1M 输出 token 收费 $0.6468,页面标注 51% 折扣。
- 缓存输入折扣:多数语言模型提供大幅优惠的缓存输入 token 价格,例如 DeepSeek-V4-Flash-0731 缓存输入为 $0.015/百万,非缓存为 $0.06。
- 限时折扣:部分模型带有限时折扣,包括 Xiaomi MiMo 系列 5–10% 折扣、DeepSeek-V4.1-Flash 30% 折扣及 GLM-5.3 38% 折扣。
- GPU 租用:提供按需 DGX B300 GPU 实例,价格为 $5.89/实例小时。
适用人群
- 希望快速集成大模型能力的应用开发者与创业团队:借助兼容 OpenAI 的接口和丰富的模型选择,可以在短时间内为产品接入对话、生成、检索等 AI 能力,加快上线节奏。
- 需要低成本验证 AI 产品想法的产品经理:按量计费的模式让原型验证和小规模试点的成本可控,无需前期投入大量基础设施预算即可快速测试市场需求。
- 预算有限但追求推理性能的中小型企业:以远低于自建 GPU 集群的投入获得稳定的推理性能,同时免去基础设施运维负担,把节省下来的资源投入核心业务。
- 进行模型实验与研究的学生和科研人员:可以便捷地调用各类主流开源模型,用于学习、对比实验与学术研究,无需自建昂贵的实验环境。
相关教程
查看全部 →


相关工具
查看全部 → OmniRoute — Free AI Gateway for Multi-Provider LLMs Free, open-source AI router with auto-fallback. 236 providers, one endpoint, 95 MCP tools, 17 routing strategies, A2A protocol, auto-combo engine, semantic cache, memory & skills. Deploy anywhere.
 LangChain LangChain provides a comprehensive suite of products to support developers throughout their entire development workflow.
 OpenHands Open-source, model-agnostic platform for building and deploying cloud coding agents. Automate real engineering work securely with full transparency and control.
 Agent-Native — Agent-Native Apps Framework Build agentic apps where AI agents and UI share the same database and state. Open source framework with ready-to-fork templates.
 DeepSeek V4.1 Flash DeepSeek是一家专注于研发通用人工智能底层模型与技术的公司,基于自研训练框架和强大算力资源,已开源多个高性能百亿参数大语言模型。