简介
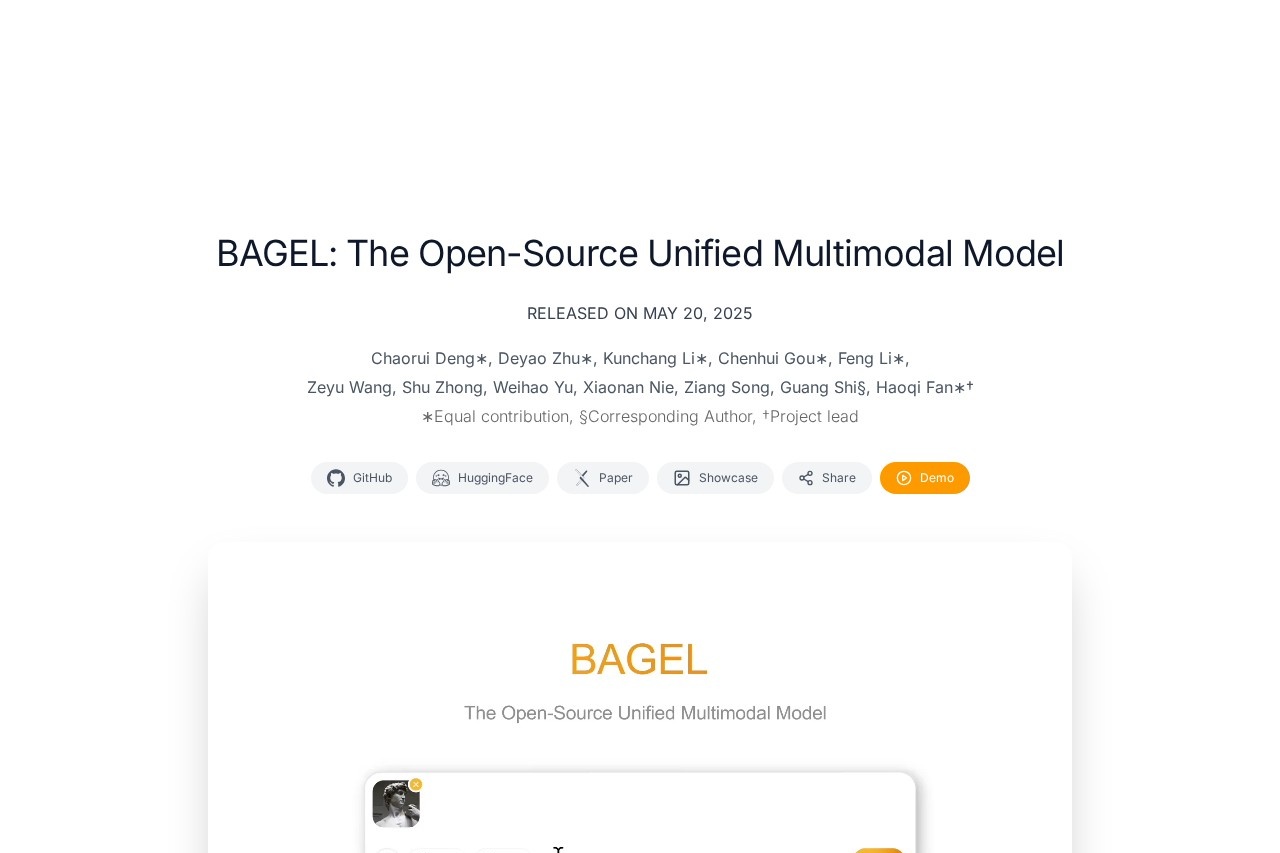
Bagel 是一个开源的统一多模态 AI 模型,旨在把视觉理解、图像生成和图像编辑整合到同一个系统中。它不依赖为各任务分别设计的专用模型,而是让开发者和研究人员用一个模型完成图像解读、新图像生成和已有图像修改。
项目官网将其定位为"开源统一多模态模型"(The Open-Source Unified Multimodal Model),与其他面向社区使用和实验的公开发布基础模型处于同一行列。由于代码和权重开放,用户可以查看模型的工作方式,将其适配到自己的应用中,并在条件允许时本地运行。对于希望获得灵活性、而非仅使用封闭 API 服务的多模态应用团队来说,Bagel 是一个可选方案。
主要功能
统一多模态架构:单一模型覆盖视觉理解、生成和编辑,减少串联多个工具的需要。
开源发布:项目以开源模型形式发布,开发者可在其许可条款下研究、修改和部署。
视觉理解:模型可解读和描述视觉输入,支持需要从图像中读取信息的任务。
图像生成:Bagel 能生成图像,可用于创意和原型用途的文生图工作流。
图像编辑:模型可按指令修改已有图像,与其理解和生成能力互为补充。
可自部署:作为开源模型,可在用户自有基础设施上运行,而非只能通过托管服务使用,具体取决于硬件条件。
定价与费用
- 定价:在我们审阅的页面上未公开列出;请前往官网查询最新方案。
- 开放获取:官网 bagel-ai.org 将该模型呈现为开源。
- 范围限制:所审阅的公开页面仅提供概括性描述;详细技术规格、基准测试结果和许可条款应在官网或代码仓库中确认。
适用人群
Bagel 主要面向希望使用开源多模态模型完成图像理解、生成和编辑的 AI 开发者与机器学习研究人员。它适合试验基础模型的开源贡献者、开发整合多种视觉任务应用原型的计算机视觉工程师,以及偏好自部署模型而非商业 API 的团队。拥有合适硬件的爱好者也可以用它进行本地图像生成和编辑实验。
常见问题
Bagel 是什么?Bagel 是一个开源的统一多模态 AI 模型,将视觉理解、图像生成和图像编辑整合在单一系统中。
Bagel 免费吗?该模型以开源形式呈现,但我们审阅的页面上未公开列出详细定价或托管条款;请查看官网获取最新信息。
Bagel 能做什么?根据官方描述,它可以在一个模型内完成视觉理解、图像生成和图像编辑任务。
Bagel 可以自部署吗?作为开源模型,它设计为可供用户查看和部署,但硬件要求和许可条款应在官网上核实。
在哪里可以找到 Bagel 的更多详情?官网 bagel-ai.org 是主要信息来源;详细文档和技术细节应在该处确认。
相关教程
查看全部 →

相关工具
查看全部 → Civitai Civitai 是一个面向 AI 创作者和 Stable Diffusion 用户的在线社区,可发布、发现和下载社区贡献的图像生成模型。
 Qwen AI - 阿里巴巴千问海外版 通义千问是由阿里云开发的大型语言模型,提供智能对话与文本生成服务。
 Hugging Face Hugging Face 是一个开放的机器学习社区平台,供从业者托管、发现并协作开发超过两百万个模型、数据集和 AI 应用。
 Llama Llama 4提供高性能、多模态、低成本的领先AI模型Scout和Maverick。
 LTX 2 AI Video Generator - Create Stunning Videos Free Online Transform your ideas into amazing AI-generated videos with LTX 2 Video Generator. Create professional videos online for free. No experience required. Start generating now.