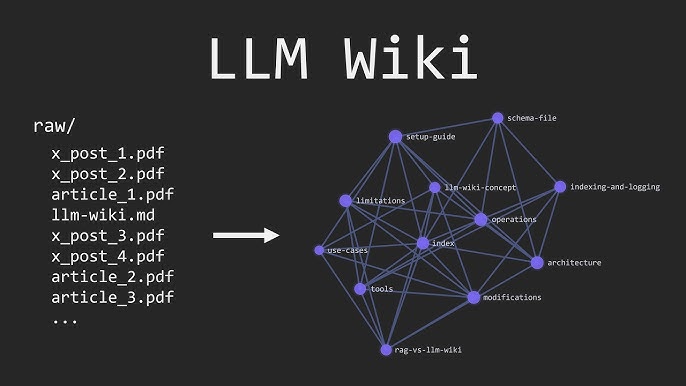
在信息过载的时代,我们的大脑不再是知识的容器,而应成为知识的连接器。当AI成为我们的认知副驾,如何让"第二大脑"与AI无缝协作?
前言:为什么需要"与AI兼容"的第二大脑?
传统的"第二大脑"概念(由Tiago Forte的PARA方法、BASB方法论等推广)强调个人知识管理——捕捉、组织、提炼和表达信息。但在AI时代,这一概念需要进化。
我们不再仅仅是为自己构建知识库,而是在构建一个人机协作的知识生态系统。一个与AI兼容的第二大脑,应当让AI能够理解、访问并有效利用你的知识资产,同时保持你的主导权。
一、核心理念转变:从"人类可读"到"人机可读"
1.1 传统第二大脑的问题
传统个人知识库通常以自由文本、零散笔记、文件夹分类为主。这些内容对人类有意义("我知道这个文件放在哪里"),但对AI而言是语义迷雾。
1.2 与AI兼容的设计原则
| 传统方式 | AI兼容方式 |
|---|---|
| 长段落叙述 | 结构化、原子化单元 |
| 隐式关联 | 显式链接和关系标注 |
| 自由标签 | 语义一致的分类体系 |
| 单一文本格式 | 多模态+元数据 |
| 依赖记忆检索 | 依赖可编程检索 |
核心原则:让你的知识既能被人类理解,也能被向量化、索引和语义检索。
二、构建AI兼容第二大脑的五个层次
层次1:原子化知识单元(Atomic Notes)
每个笔记只表达一个明确的概念、事实或想法。长度控制在100-300字之间。
❌ 不好的例子:
"人工智能第二大脑会议笔记 - 讨论了RAG、知识图谱、embedding模型选择,还有数据隐私问题,另外午餐不错..."

✅ 好的例子:
标题:「RAG检索增强生成的定义」
内容:RAG是一种结合信息检索和文本生成的技术架构...
相关概念:[[Embedding]]、[[向量数据库]]、[[上下文窗口]]AI兼容要点:原子化单元便于向量化、切片和精确检索。
层次2:语义元数据架构
为每个知识单元添加三层元数据:
---
title: "RAG检索增强生成的定义"
type: concept
created: 2025-01-15
domain: ai-architecture
confidence: high
related: ["Embedding", "向量数据库"]
difficulty: intermediate
---AI兼容要点:结构化元数据使AI能够进行条件检索、过滤和推理。
层次3:显式知识图谱链接
不要只依赖文件夹或标签,建立双向显式链接:
[[概念A]]链接到[[概念B]]- 使用链接类型标注:
[[论文X]] ->(反驳) [[论文Y]]
推荐工具:Obsidian、Roam Research、Logseq天然支持这种格式。
AI兼容要点:链接关系可以被AI解析为图结构,支持路径检索和关系推理。
层次4:可执行的查询接口
与AI兼容的第二大脑不应只是一个静态仓库,而应提供:
- 语义搜索API(通过embedding)
- 按时间范围查询
- 按概念相关性检索
- 差异查询("上周新增了哪些关于X的知识?")
可以构建在Notion API、Obsidian Publish + Cloudflare Worker,或本地Vector数据库(如Chroma、Qdrant)之上。
AI兼容要点:让AI能够以编程方式访问你的知识,而非通过对话"翻笔记"。
层次5:AI协作工作流
将AI集成到知识摄入和产出流程中:
摄入流程:
原始信息 → AI摘要 → 提取原子概念 → 链接现有知识 → 存入

产出流程:
查询意图 → AI检索相关单元 → 组织结构 → 草稿生成 → 人工修订
具体实践:使用AI自动生成笔记摘要、识别重复内容、建议缺失链接。
AI兼容要点:AI不是旁观者,而是知识循环中的参与者。
三、实践架构:一个最小可行方案
3.1 工具链推荐
| 层次 | 推荐工具 | 替代选项 |
|---|---|---|
| 笔记编辑 | Obsidian | Logseq, Anytype |
| 双向链接 | Obsidian原生 | Roam Research |
| 元数据管理 | YAML frontmatter | Dataview插件 |
| 向量化存储 | Obsidian Copilot + 本地embedding | Notion + Make.com |
| AI查询接口 | LangChain + 本地向量库 | Flowise, Dify |
| 知识图谱可视化 | Obsidian Graph | Neo4j (大规模) |
3.2 目录结构(简化版PARA)
第二大脑/
├── 00_Inbox/          # 原始捕获
├── 10_AtomicNotes/    # 原子知识(按领域)
│   ├── ai/
│   ├── productivity/
│   └── personal/
├── 20_Concepts/       # 概念卡片
├── 30_Relations/      # 关系映射(MOC - Maps of Content)
├── 40_Projects/       # 项目知识
└── 50_Archives/       # 归档
3.3 每周AI兼容性检查清单
- [ ] 新笔记是否拆分到原子粒度?
- [ ] 每个笔记是否有YAML元数据?
- [ ] 是否建立了
[[双向链接]]? - [ ] AI能否通过语义检索找到关键概念?
- [ ] 是否有任何知识只存在于我的大脑中?
四、常见误区与解决方案
误区1:过度结构化
问题:花80%时间维护元数据和链接,而不是创造知识。
解决:接受"足够好"原则。只标注AI检索必需的字段。使用AI自动生成建议的元数据和链接。
误区2:工具链过重
问题:搭建了复杂系统,但三天后放弃维护。
解决:从纯文本Markdown + Obsidian开始。两周后再考虑向量数据库。
误区3:忽视AI的局限性
问题:期待AI完美理解你的隐喻、情绪和隐式背景。
解决:关键决策知识和高度个性化内容保留为人类专用格式。AI兼容层用于可显式表达的知识。
五、未来展望:知识资产的互操作
随着AI模型的发展,与AI兼容的第二大脑将不仅是个人工具,而是知识资产协议的基础:
- 标准化的知识交换格式(如知识图谱的RDF、属性图的GQL)
- 个人知识空间的互操作(不同人的第二大脑可以安全协作)
- AI代理间的知识委托("帮我查一下我的第二大脑中关于X的所有信息")
我们正在从"拥有知识"转向"可被AI调用的知识"。
结论:你的大脑是指挥官,不是仓库
构建与AI兼容的第二大脑,本质上是重新定义人机认知分工:
- 人类负责:提出好问题、建立创造性连接、做价值判断
- 第二大脑负责:可靠存储、结构化管理、快速检索
- AI负责:语义理解、模式识别、内容生成、关系建议
三者形成闭环。你不需要记住一切,也不需要手工组织一切。你需要的是设计一个让AI能够有效协作的知识架构。
从今天开始,选择三个原子笔记,添加YAML元数据和双向链接。你的AI伙伴会感谢你。
延伸阅读:
- 本系列下一篇:「从笔记到知识图谱:用向量数据库增强你的第二大脑」
本文是LLM-WIKI系列的一部分。LLM-WIKI致力于构建人类与AI共享的知识框架。