Introdução
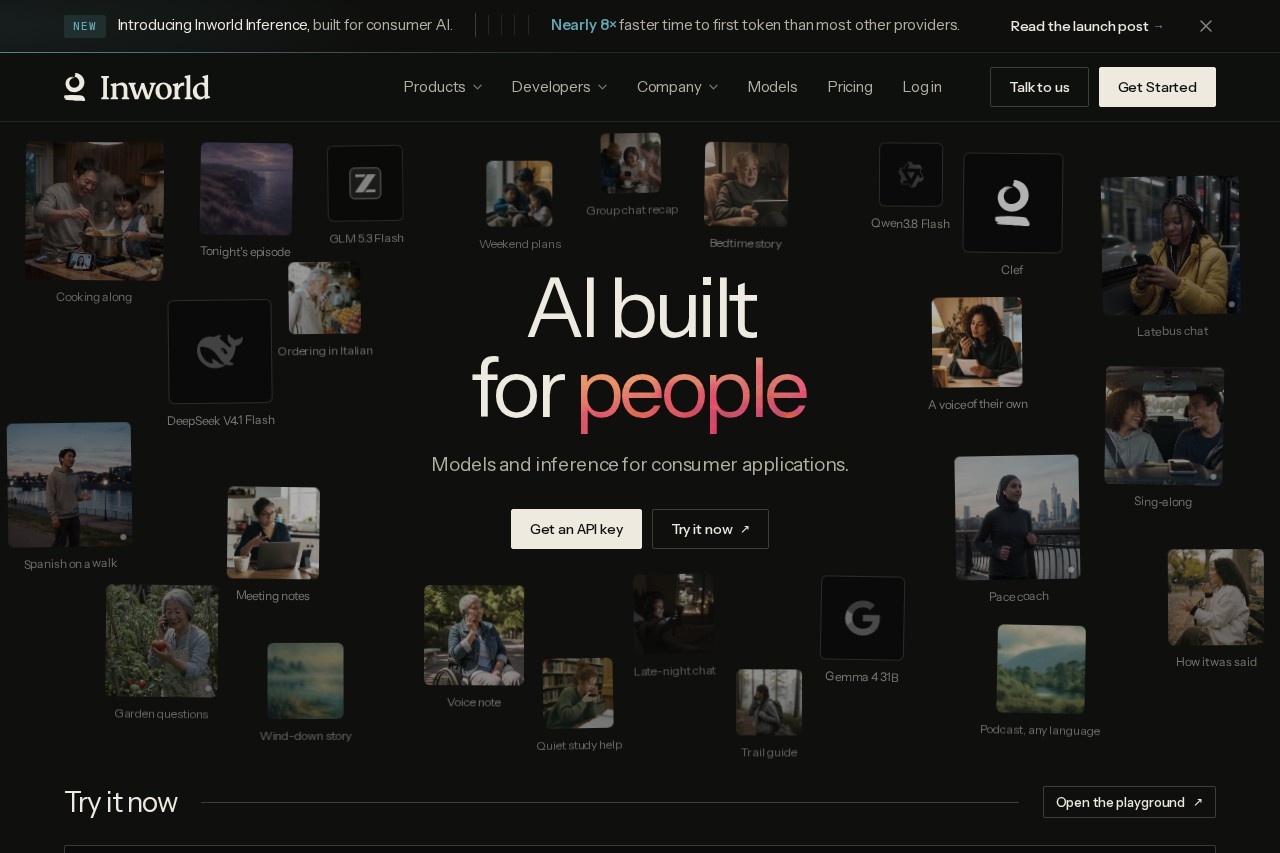
A Inworld AI é uma plataforma de modelos de voz em tempo real e grandes modelos de linguagem abertos hospedados, voltada para aplicativos voltados ao consumidor. Ela resolve o problema de adicionar recursos naturais de fala e linguagem com baixa latência a apps como companheiros de IA, tutores, coaches de bem-estar, agentes de voz para suporte e vendas, e jogos e mídias interativas, sem que a equipe precise operar sua própria infraestrutura de modelos.
A empresa oferece modelos de fala (Realtime TTS-2 e TTS-2 Flash para texto em fala, Realtime STT-1 para fala em texto e um produto de fala para fala para conversas completas por voz), além do Inference, uma API compatível com OpenAI que serve LLMs abertos em uma frota operada pela Inworld. Cada modelo tem sua própria API e podem ser combinados; também há uma opção de Compute para implantações dedicadas. A Inworld afirma que o primeiro áudio pode chegar em apenas 50 ms e que processa dezenas de trilhões de tokens por mês.
Principais Recursos
- Realtime TTS-2 texto para fala: Fala cerca de 500 idiomas e dialetos, aceita direções de voz em linguagem natural como
[whisper]e suporta timestamps de palavras e timings de visemas para sincronização labial. - Realtime TTS-2 Flash: O modelo mais rápido da família, com a mesma cobertura de idiomas, com tempo P90 até o primeiro áudio tão baixo quanto 20 ms no lado do servidor; ignora tags de direção, mas reproduz sons não verbais como
[laugh]. - Fala para fala: Uma única conexão que escuta, raciocina e fala, via WebSocket ou WebRTC, seguindo o protocolo OpenAI Realtime com detecção de turnos, interrupções e chamadas de ferramentas.
- Realtime STT-1 fala para texto: Transcreve 30 idiomas e retorna um perfil de voz com cada transcrição, cobrindo idade, emoção, tom, estilo vocal e sotaque, com diarização de falantes disponível experimentalmente.
- Inworld Inference: Hospeda modelos abertos incluindo Gemma 4, GLM 5.3 Flash, MiMo 2.6 Pro, DeepSeek V4.1 Flash e o modelo de decisões Clef por meio de uma API compatível com OpenAI.
- Clonagem e design de voz: Clonagem instantânea a partir de cerca de 3 segundos de áudio, além da possibilidade de desenhar uma voz a partir de uma descrição escrita.
- Infraestrutura global: Entrega de voz em quatro regiões (EUA, Europa, Índia, Ásia-Pacífico) em cinco sites, com serving de LLM nos EUA e conformidade SOC 2 Type II, HIPAA e LGPD/GDPR.
Destaques
- Preços: Os planos são baseados em créditos e começam com um nível gratuito On-Demand (TTS-2 a $25/1M caracteres, TTS-2 Flash a $15/1M caracteres, STT-1 a $0,15/hora, inferência de LLM a partir de $0,07/1M tokens). Os planos pagos são Creator a $25/mês, Builder a $100/mês, Developer a $300/mês e Growth a $1.500/mês, cada um adicionando créditos mensais e descontos de até cerca de 47% nas tarifas de TTS e STT. Em escala empresarial, o TTS-2 Flash cai para $5/1M caracteres.
- Nível gratuito: O plano On-Demand custa $0 com tarifas pay-as-you-go, incluindo até 70 minutos de TTS, 100 vozes personalizadas e 2 clones de voz profissionais.
- Integrações: As vozes da Inworld funcionam dentro do LiveKit Agents sem uma segunda chave de API, e a empresa publica uma "skill" que pode ser colada em agentes de codificação como Claude Code ou Cursor.
- Confiabilidade e escala: A Inworld reporta 99,999% das requisições atendidas para seu LLM Priority e modelos de voz, com menos de 1 em 100.000 requisições falhando em uma janela de medição de 30 dias.
Para Quem É
A Inworld AI foi criada para equipes de engenharia que desenvolvem aplicativos para consumidores com os quais as pessoas conversam todos os dias. Isso inclui desenvolvedores de apps de companheiros de IA e sociais, tutores de idiomas e produtos educacionais, coaches de saúde e fitness, agentes de voz para suporte ao cliente e operações de vendas, e estúdios que criam jogos e mídias narradas que precisam de diálogos ao vivo e vozes de personagens expressivas. A API de inferência compatível com OpenAI também atende equipes que desejam LLMs abertos servidos por terceiros em vez de gerenciar sua própria frota de GPUs.