Introdução
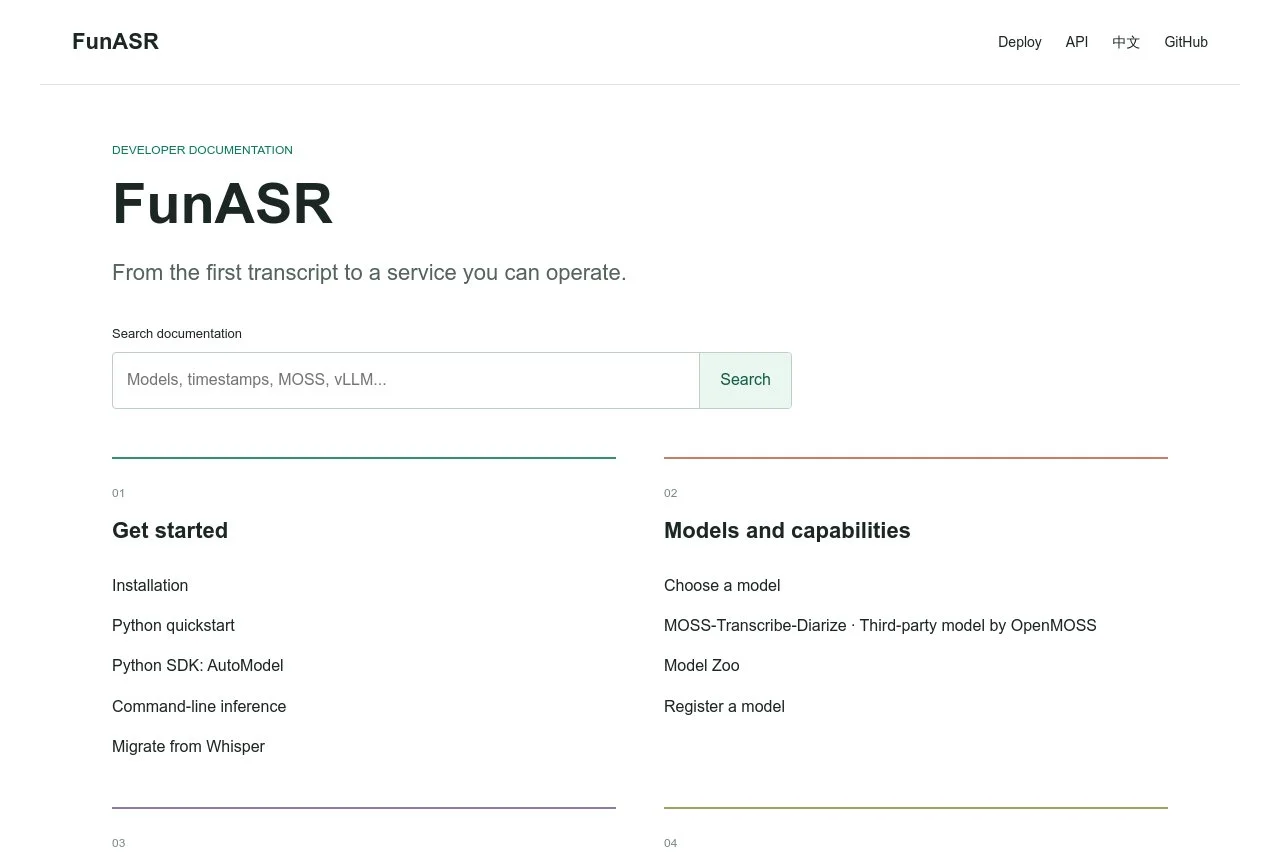
FunASR é um kit de ferramentas de reconhecimento de fala ponta a ponta de código aberto, projetado para aplicações de nível industrial, desenvolvido e mantido continuamente pelo laboratório de fala da Alibaba DAMO Academy. Ele integra um conjunto completo de capacidades de processamento de fala, desde reconhecimento de fala e diarização de falantes até detecção de emoções. O kit alcança velocidades de inferência até 170 vezes o tempo real em GPU e suporta reconhecimento em mais de 50 idiomas. O FunASR oferece uma interface de API compatível com OpenAI e utiliza aceleração vLLM para aumentar significativamente a eficiência de inferência de grandes modelos, permitindo integração perfeita em sistemas de agentes. É uma escolha ideal para construir aplicações de interação por voz de alta precisão e baixa latência.
Principais Recursos
- Reconhecimento de fala de alta precisão: Baseado em aprendizado autor supervisionado avançado e modelos ponta a ponta, mantém precisão de reconhecimento estável em diversos ambientes ruidosos.
- Suporte a múltiplos idiomas: Cobre mais de 50 idiomas, incluindo chinês, inglês, japonês, coreano, francês, alemão e dialetos selecionados.
- Diarização de falantes: Distingue automaticamente diferentes falantes e gera transcrições de conversas com rótulos.
- Detecção de emoções: Analisa o tom emocional da fala em tempo real, com suporte à classificação de emoções comuns como raiva, alegria e tristeza.
- Modos duplos de streaming e offline: Suporta reconhecimento em streaming em tempo real, bem como processamento offline em lote de arquivos de áudio completos, adaptando-se com flexibilidade a diferentes cenários de negócio.
- Integração com agentes: Fornece interfaces padronizadas para incorporar rapidamente capacidades de fala em atendimento ao cliente inteligente, assistentes de voz e outros sistemas de agentes.
Destaques
- Preços: Não divulgados publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Kit de ferramentas de código aberto: O FunASR está hospedado no GitHub e pode ser instalado e executado localmente, de modo que a inferência principal não tem custo por chamada.
- Implantação flexível: Suporta vLLM nativo, um modo vLLM de engine dividida e llama.cpp com modelos GGUF, permitindo que os usuários escolham a infraestrutura adequada ao seu orçamento e hardware.
- API compatível com Whisper: Oferece uma interface compatível com OpenAI, permitindo que integrações OpenAI/Whisper existentes sejam migradas sem reescrita de código.
Para Quem É
O FunASR é ideal para desenvolvedores de aplicações de IA que desejam adicionar rapidamente reconhecimento de fala, diarização de falantes ou análise de emoções aos seus produtos, reduzindo custos de desenvolvimento próprio. Também atende equipes técnicas corporativas que precisam implantar serviços de fala de alta concorrência e baixa latência para centrais de atendimento, transcrição de reuniões, legendagem ao vivo e cenários semelhantes. Desenvolvedores que trabalham com agentes e soluções de RPA podem integrar interação por voz em fluxos de trabalho de agentes para automação orientada por voz. Pesquisadores acadêmicos encontrarão nele um sistema de referência flexível e reproduzível para experimentos e comparações em tecnologias de fala.