Introdução
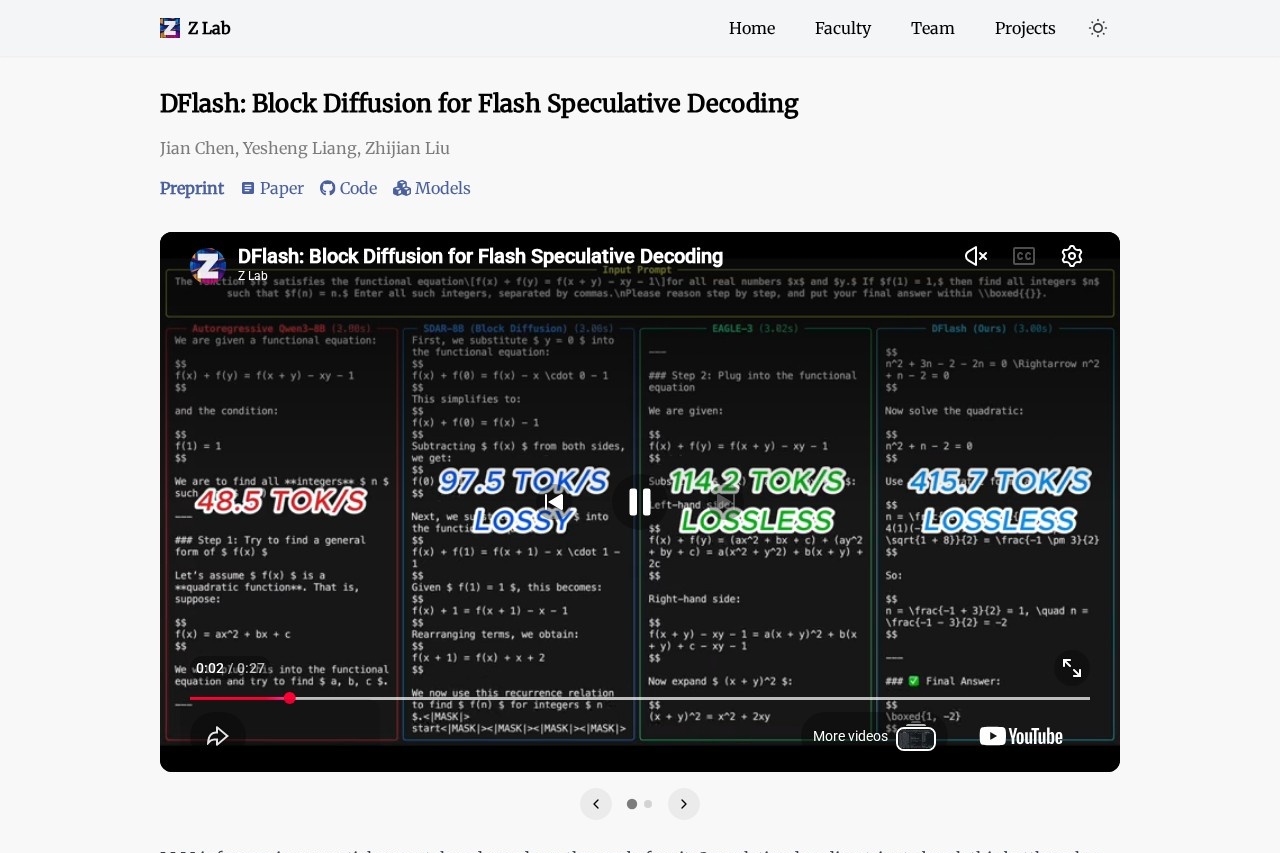
DFlash: Block Diffusion for Flash Speculative Decoding é uma tecnologia de ponta desenvolvida pela Z Lab, projetada para enfrentar os gargalos de eficiência na inferência de grandes modelos de linguagem. Os métodos tradicionais de decodificação autorregressiva oferecem alta precisão, mas a velocidade de geração é limitada pela computação token a token, o que dificulta o atendimento às demandas de aplicações em tempo real. Ao combinar um mecanismo de difusão em blocos com decodificação especulativa, o DFlash aumenta significativamente a vazão da inferência sem comprometer a qualidade da geração. Essa tecnologia é especialmente adequada para sistemas de diálogo de resposta rápida, ferramentas de geração de conteúdo e cenários de implantação em edge, oferecendo aos desenvolvedores uma solução eficiente e escalável.
Principais Recursos
- Decodificação Especulativa com Difusão em Blocos: Usa um modelo de difusão para gerar múltiplos blocos candidatos de tokens em paralelo, em conjunto com um verificador leve para triagem rápida, reduzindo substancialmente o número de etapas de decodificação.
- Inferência de Baixa Latência: Aproveita pré-computação e otimização de cache para reduzir a latência de inferência única a 30%-50% dos métodos tradicionais.
- Integração Perfeita: Compatível com frameworks populares de aprendizado profundo como PyTorch e TensorFlow, e oferece uma interface de API limpa para fácil integração em fluxos de trabalho existentes.
- Ajuste Dinâmico de Recursos: Ajusta automaticamente o tamanho dos blocos e o paralelismo com base na configuração de hardware para equilibrar velocidade e uso de memória.
Destaques
- Preços: Não divulgados publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Código e modelos abertos: O artigo, o código e os modelos draft pré-treinados do DFlash (ex.: z-lab/Qwen3-8B-DFlash-b16, z-lab/Qwen3-Coder-30B-A3B-DFlash) estão publicamente disponíveis para download e auto-hospedagem.
- Disponibilidade em frameworks: Compatível com SGLang para servição em produção e Hugging Face Transformers para experimentação rápida; a integração com vLLM está em andamento.
- Alegação de desempenho: Relata aceleração sem perdas de até 6× no Qwen3-8B, aproximadamente 2,5× mais rápido que o EAGLE-3, no mesmo hardware.
Para Quem É
Pesquisadores e engenheiros de IA que desejam explorar novos paradigmas de decodificação e otimizar o desempenho de inferência de grandes modelos; desenvolvedores de produto que precisam integrar capacidades de IA em tempo real, como chatbots ou conclusão de código, em suas aplicações; profissionais de computação edge que implantam grandes modelos em dispositivos com recursos limitados, priorizando baixo consumo de energia e resposta rápida; e tomadores de decisão de tecnologia em empresas que avaliam opções para reduzir os custos de servição de LLMs e melhorar a experiência do usuário.