Introdução
DeepInfra é uma nuvem de inferência serverless com GPU construída para grandes modelos de linguagem de código aberto, oferecendo desempenho de nível de produção a preços acessíveis. Em vez de comprar e manter hardware de GPU caro, os desenvolvedores podem executar modelos abertos populares como Llama, Mistral, Qwen e DeepSeek por meio de chamadas de API simples, reduzindo drasticamente a barreira para a criação de aplicativos com IA.
Destaques
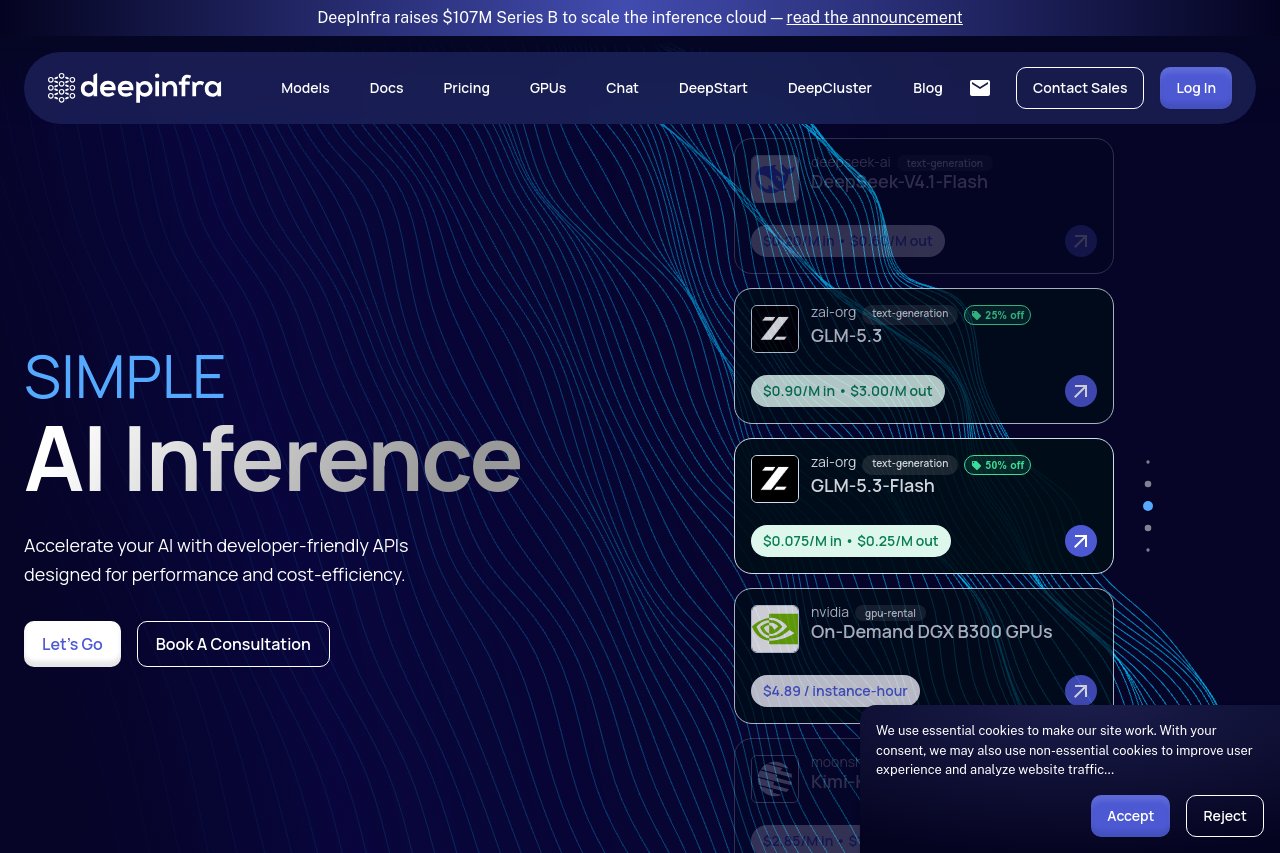
- Preços: O DeepInfra usa preços de pagamento conforme o uso, sem contratos de longo prazo ou custos antecipados. Os modelos de linguagem são cobrados por token (por exemplo, DeepSeek-V4-Flash a $0.09 por 1M de tokens de entrada / $0.18 por 1M de tokens de saída; Kimi-K3 a $2.85 / $14.25), enquanto a maioria dos outros modelos é cobrada pelo tempo de execução da inferência.
- Exemplo de preço por token: O modelo em destaque DeepSeek-V4-Flash-Vision-Exp custa $0.2156 por 1M de tokens de entrada ($0.0069 em cache) e $0.6468 por 1M de tokens de saída, com um desconto listado de 51%.
- Descontos para entrada em cache: Muitos modelos de linguagem oferecem tarifas significativamente mais baratas para tokens de entrada em cache, como $0.015 por 1M em cache para DeepSeek-V4-Flash-0731 contra $0.06 sem cache.
- Descontos promocionais: Modelos selecionados possuem descontos por tempo limitado, incluindo 5–10% de desconto nos modelos Xiaomi MiMo, 30% de desconto no DeepSeek-V4.1-Flash e 38% de desconto no GLM-5.3.
- Aluguel de GPU: Instâncias DGX B300 on-demand estão disponíveis a $5.89 por hora de instância.
Principais Recursos
- Uma ampla biblioteca de modelos de código aberto cobrindo geração de texto, chat, embeddings, geração de imagens e reconhecimento de fala
- API compatível com OpenAI, permitindo que códigos existentes sejam migrados com alterações mínimas
- Implantação serverless com pagamento por token, além de instâncias dedicadas de GPU
- Escalonamento automático que aloca recursos de computação com base no tráfego em tempo real
- Fine-tuning e hospedagem de modelos personalizados privados
Por Que Ele Se Destaca
O grande diferencial da plataforma é a eficiência de custos: o faturamento por token mantém as despesas muito abaixo de clusters de GPU autogerenciados ou APIs proprietárias. Cold starts rápidos e baixa latência de inferência tornam-no confiável para cargas de trabalho de produção com alta concorrência. O DeepInfra também enfatiza a privacidade, afirmando que as solicitações dos usuários não são usadas para treinamento de modelos, o que dá confiança às equipes ao lidar com dados sensíveis.
Para Quem É
- Desenvolvedores de aplicativos e startups integrando capacidades de LLM
- Equipes de produto validando ideias de IA com orçamento limitado
- Pequenas e médias empresas buscando forte desempenho de inferência sem sobrecarga de infraestrutura
- Estudantes e pesquisadores experimentando modelos de código aberto