Introdução
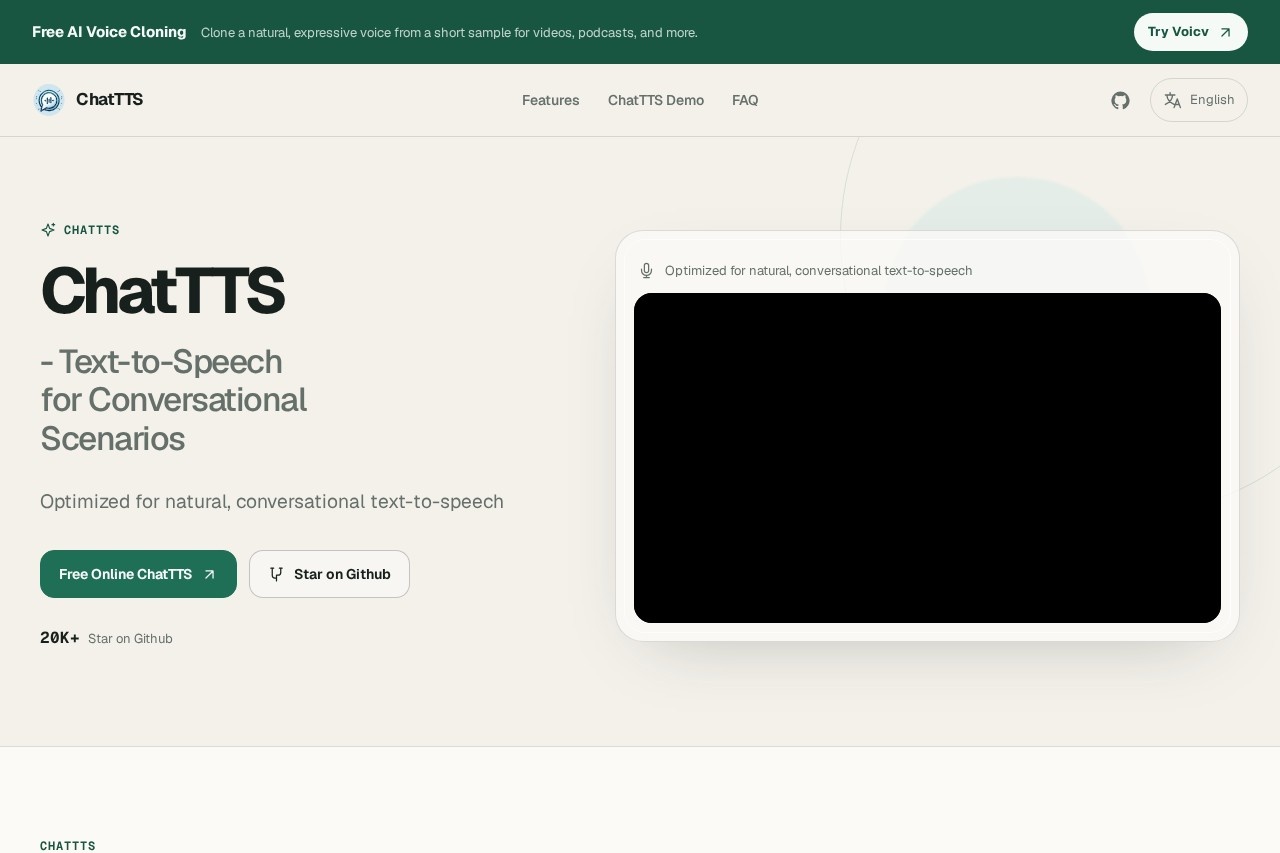
ChatTTS é um modelo de geração de voz construído especificamente para texto-para-fala conversacional. Em vez de focar em narração ou leitura de textos longos, ele foi projetado para renderizar diálogos de forma natural, o que o torna adequado para as respostas faladas de assistentes baseados em grandes modelos de linguagem e para introduções em áudio e vídeo de cunho conversacional.
O modelo suporta chinês e inglês e foi treinado com aproximadamente 100.000 horas de dados de fala nesses dois idiomas, o que, segundo o projeto, explica a naturalidade de sua saída. O código é distribuído pelo GitHub no repositório 2noise/ChatTTS, e a equipe do projeto anunciou planos de lançar um modelo base de código aberto para que pesquisadores acadêmicos e desenvolvedores possam estudar e ampliar a tecnologia. O site oficial também oferece uma demonstração online gratuita, onde os visitantes podem ouvir o modelo gerar fala a partir de textos de exemplo sem instalar nada.
Principais Recursos
- Suporte bilíngue: O ChatTTS gera fala em chinês e inglês, então um único modelo pode atender aplicações multilíngues sem a necessidade de trocar de ferramenta.
- Síntese focada em diálogo: O modelo é otimizado para texto conversacional em vez de narração formal, produzindo fala adequada a trocas de mensagens e respostas de assistentes.
- Grandes volumes de dados de treinamento: O treinamento cobriu aproximadamente 100.000 horas de áudio em chinês e inglês, base da qualidade de voz, segundo a equipe.
- Entrada simples: O usuário fornece apenas texto; o modelo retorna um arquivo de áudio correspondente, mantendo o fluxo de trabalho direto.
- Planos de código aberto: A equipe pretende lançar um modelo base treinado para a comunidade de pesquisa e desenvolvimento.
- Trabalho de controle e segurança: Os esforços em andamento incluem melhorar a controlabilidade, adicionar marcas d'água ao áudio gerado e integrar o modelo com LLMs.
- Acesso programático: Desenvolvedores clonam o repositório, instalam o pacote com pip e chamam uma pequena API em Python para gerar fala.
Destaques
- Preços: Não estão listados publicamente nas páginas que analisamos; consulte o site oficial para os planos atuais.
- Demonstração online gratuita: O site oficial oferece uma demo no navegador com textos de exemplo, embora possa exibir a mensagem "serviço ocupado" sob alta demanda.
- Código para auto-hospedagem: O pipeline completo está disponível no GitHub, permitindo que desenvolvedores o executem localmente com PyTorch.
- Saída de áudio: Os scripts de exemplo reproduzem o áudio gerado a uma taxa de amostragem de 24.000 Hz.
Para Quem É
O ChatTTS é voltado principalmente para desenvolvedores e pesquisadores que constroem aplicações conversacionais, especialmente aqueles que adicionam saída falada a assistentes baseados em grandes modelos de linguagem. Também serve a equipes que produzem conteúdo de áudio com forte carga de diálogo, como introduções em vídeo, narrações educacionais e de treinamento, e qualquer serviço que precise converter texto em fala natural em chinês ou inglês. Como o código está no GitHub e a equipe planeja um modelo base aberto, acadêmicos que estudam síntese de fala podem inspecioná-lo e desenvolvê-lo diretamente, em vez de tratá-lo como um serviço fechado tipo caixa-preta.