Introdução
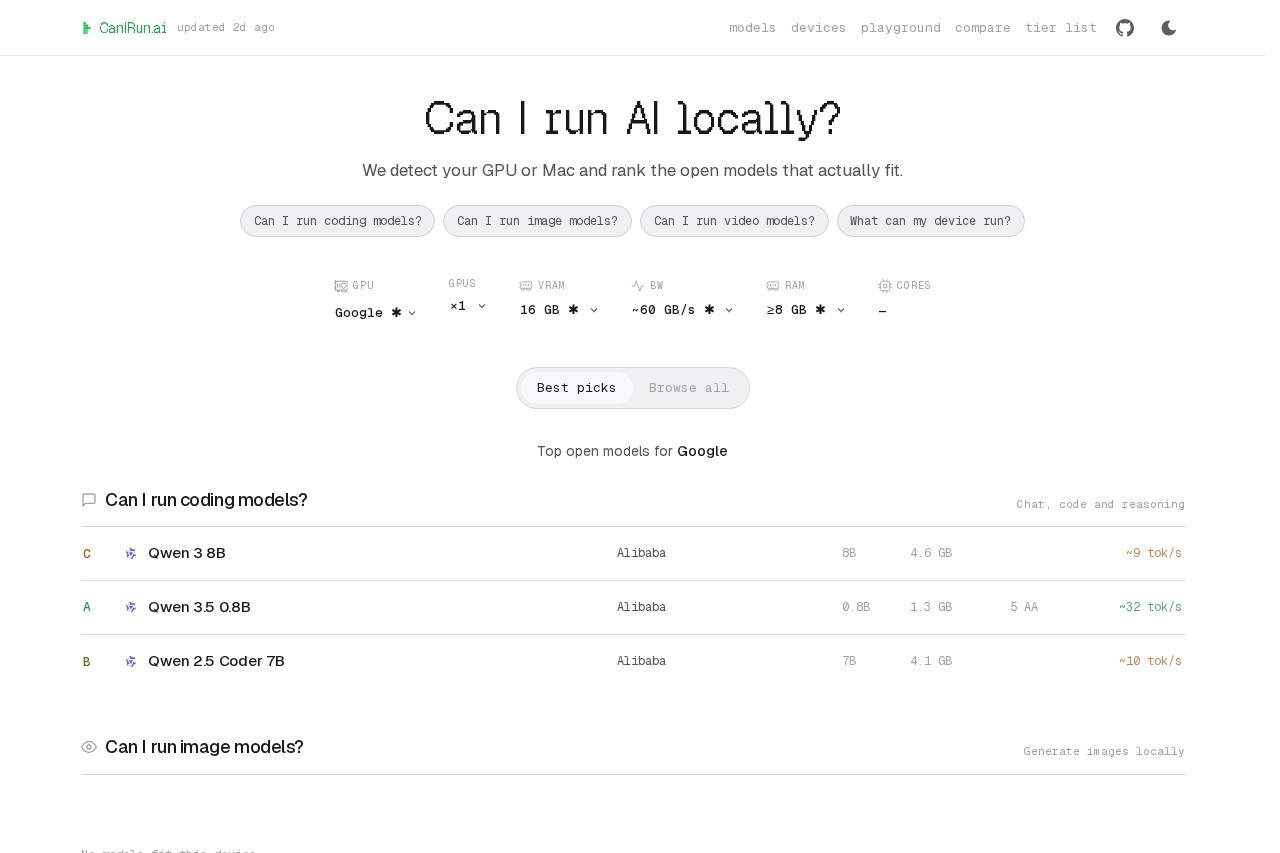
O CanIRun.ai responde a uma pergunta que todo usuário de IA local acaba enfrentando: meu computador realmente consegue rodar esse modelo? Em vez de adivinhar os requisitos de VRAM ou baixar modelos por tentativa e erro, o site detecta sua GPU ou Mac diretamente no navegador e avalia todo um catálogo de modelos de pesos abertos contra o seu hardware específico. Cada modelo recebe uma nota de S até F, com base na velocidade estimada, na margem de VRAM e na qualidade do modelo, para que os usuários vejam de relance o que roda confortavelmente, o que é um encaixe apertado e o que está fora de alcance.
O site organiza seu catálogo em quatro categorias de tarefas: modelos de chat, código e raciocínio; geração de imagens; geração de vídeos; e modelos pequenos on-device de 4B parâmetros ou menos. A cobertura inclui lançamentos da Alibaba, Meta, Google, OpenAI, Black Forest Labs, Tencent, Ideogram, Krea, Lightricks e outros, com filtros por licença, popularidade, comprimento de contexto, velocidade e VRAM. Também oferece páginas que listam modelos por família de dispositivos, incluindo placas gráficas RTX e Radeon, Apple Silicon, celulares e Raspberry Pi, além de faixas de VRAM de 8GB a 32GB e mais. O preço não está publicamente listado nas páginas que analisamos; consulte o site oficial para ver os planos atuais.
Principais Recursos
- Detecção automática de hardware: O site lê sua GPU ou Mac e informa VRAM, largura de banda de memória, RAM e contagem de núcleos, e então classifica os modelos de acordo com essas especificações, sem qualquer entrada manual.
- Notas de A a F para cada modelo: Cada modelo aberto recebe uma nota de S a F, combinando velocidade estimada de execução, margem de VRAM e qualidade do modelo, para que os usuários separem rapidamente as opções confortáveis das apertadas e das inviáveis.
- Navegação por tarefa: Seções separadas respondem "Consigo rodar modelos de programação?", "Consigo rodar modelos de imagem?", "Consigo rodar modelos de vídeo?" e "Consigo rodar modelos pequenos?" para modelos on-device de 4B parâmetros ou menos.
- Catálogo de modelos filtrável: Os usuários podem filtrar por criador (Alibaba, Meta, Google, OpenAI, Tencent e mais), tipo de licença (Apache 2.0, MIT, variantes não comerciais) e tarefa, e ordenar por pontuação, parâmetros, comprimento de contexto, velocidade, VRAM ou popularidade.
- Detalhes de quantização por modelo: As páginas de modelos mostram os níveis de quantização disponíveis, como Q2_K até Q8_0 e F16, junto com contagens de parâmetros, arquitetura (densa ou MoE, incluindo parâmetros ativos), datas de lançamento e tamanhos da janela de contexto.
- Páginas por dispositivo e VRAM: Páginas dedicadas listam modelos adequados por família de hardware (RTX, Radeon, Intel Arc, Apple Silicon, celulares, Raspberry Pi) e por faixa de VRAM (8GB, 12GB, 16GB, 24GB, 32GB+).
- Documentação de referência: A seção de docs explica quantização, requisitos de VRAM, modelos mixture-of-experts e o formato GGUF para usuários que desejam entender os números por trás das notas.
Destaques
- Preço: Não está publicamente listado nas páginas que analisamos; consulte o site oficial para ver os planos atuais.
- Plataforma: Roda no navegador; a detecção de hardware funciona para GPUs e Macs, e o catálogo de dispositivos também cobre celulares e Raspberry Pi.
- Cobertura de modelos: Inclui modelos de pesos abertos da Alibaba (Qwen, Wan, Z-Image), Meta, Google, OpenAI (GPT-OSS), Black Forest Labs (FLUX.2), Tencent (Hunyuan), Ideogram, Krea, Lightricks e mais.
- Ferramentas adicionais: A navegação do site inclui um playground, uma visualização de comparação e um tier list junto com os catálogos principais de modelos e dispositivos.
- Transparência de licenças: Cada entrada de modelo indica sua licença, como Apache 2.0, MIT ou uma licença não comercial, para que os usuários verifiquem os direitos de uso comercial antes de baixar.
Para Quem É
O CanIRun.ai é feito para qualquer pessoa que queira rodar modelos de IA localmente em vez de usar uma API na nuvem. Isso inclui entusiastas montando um setup de IA em casa, desenvolvedores escolhendo um modelo de programação ou raciocínio que caiba na placa gráfica deles, e criadores avaliando se o hardware deles consegue lidar com geração local de imagens ou vídeos. É igualmente útil para quem está planejando comprar uma GPU e quer ver qual faixa de VRAM desbloqueia quais modelos, e para donos de máquinas modestas que procuram os modelos mais leves de 4B ou menos que ainda rodam em hardware limitado.
Perguntas Frequentes
- O que é o CanIRun.ai? O CanIRun.ai é uma ferramenta baseada em navegador que detecta sua GPU ou Mac e classifica modelos de IA de pesos abertos—chat, programação, imagem e vídeo—de acordo com se podem rodar no seu hardware específico, usando velocidade estimada, margem de VRAM e qualidade do modelo.
- O CanIRun.ai é gratuito? O preço não está publicamente listado nas páginas que analisamos, então a estrutura de custos não pode ser confirmada; consulte o site oficial para ver os planos atuais.
- Quais dispositivos e hardwares ele suporta? Ele detecta GPUs e Macs no navegador e publica listas curadas de modelos para RTX, Radeon, Intel Arc, Apple Silicon, celulares e Raspberry Pi, além de faixas de VRAM de 8GB a 32GB e mais.
- Quais informações ele mostra para cada modelo? Cada entrada lista a contagem de parâmetros, a arquitetura (densa ou mixture-of-experts com contagem de parâmetros ativos), a licença, a data de lançamento, a janela de contexto, as necessidades de VRAM e os níveis de quantização disponíveis, como Q4_K_M e F16.
- O site envia meus dados de hardware para algum lugar? O site não descreve seu tratamento de dados nas páginas analisadas; a detecção de hardware acontece no navegador, mas os usuários devem revisar os termos de privacidade do site oficial para detalhes.