Introdução
Browse AI é uma plataforma sem código para extrair dados estruturados de sites e monitorar essas páginas em busca de mudanças ao longo do tempo. Scrapers tradicionais exigem habilidades de programação e costumam quebrar sempre que o layout de um site muda; o Browse AI resolve isso com uma abordagem orientada por IA que lê a página, propõe as colunas a extrair e se adapta quando o site subjacente muda.
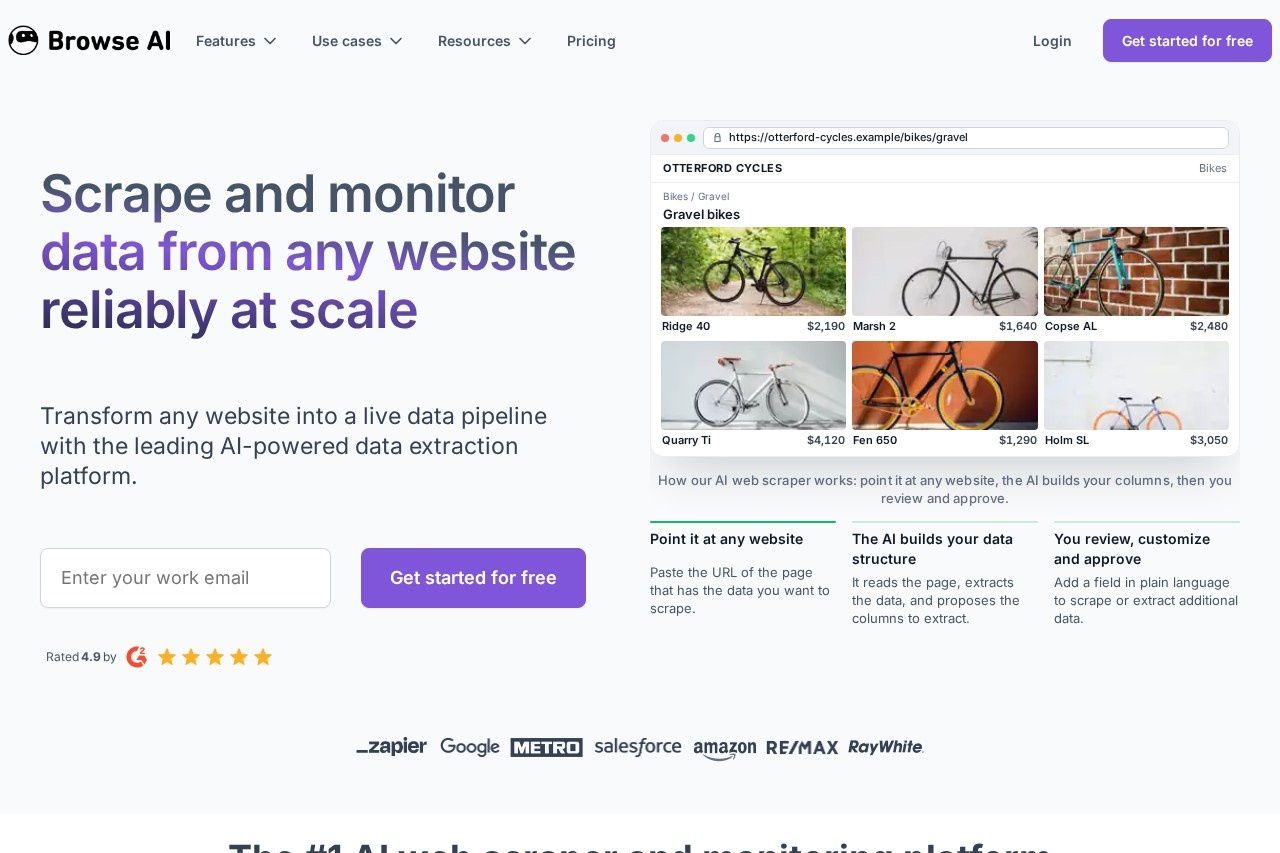
O fluxo de trabalho é deliberadamente simples. O usuário cola a URL de uma página que contém os dados desejados, o sistema analisa a página e sugere uma estrutura de dados, e o usuário revisa, ajusta e aprova — adicionando campos extras ao descrevê-los em linguagem natural. A empresa relata mais de 770.000 usuários, e a plataforma oferece integrações com mais de 7.000 aplicativos, Google Sheets, Airtable, webhooks e APIs, para que os dados extraídos fluam diretamente para as ferramentas e fluxos de trabalho automatizados existentes.
Principais Recursos
- Web scraper com IA sem código: Cole uma URL, deixe a IA propor a estrutura de dados e refine os campos em linguagem natural — sem necessidade de programação.
- Monitoramento de mudanças em sites: Agende scrapers para rodar por hora, dia, semana ou mês, com alertas quando o conteúdo da página, preços ou níveis de estoque mudarem.
- Adaptação de layout: O sistema monitora os layouts dos sites automaticamente e se ajusta para que a extração continue funcionando após atualizações de design, reduzindo falhas.
- Deep scraping em escala: Os fluxos de trabalho seguem links por páginas e subpáginas, e a plataforma foi construída para lidar com milhares de páginas da web por tarefa.
- Extração com comportamento humano: Os robots imitam ações humanas — menus suspensos, barras de busca, preenchimento de formulários — para capturar conteúdo dinâmico, com gerenciamento de proxies, novas tentativas e limitação de taxa integrados.
- Robots prontos: Mais de 200 robots prontos para uso extraem dados de sites conhecidos sem nenhuma configuração.
- Opções de exportação e integração: Envie dados para o Google Sheets, Airtable, webhooks ou uma API gerada, ou conecte-os a mais de 7.000 outros aplicativos.
Destaques
- Preços: Não divulgados publicamente nas páginas que analisamos; consulte o site oficial para ver os planos atuais. Há um plano gratuito disponível para o primeiro projeto de extração, e não é necessário cartão de crédito para se inscrever.
- Primeiro robot em minutos: A empresa afirma que os usuários podem treinar seu primeiro robot de scraping em cerca de dois minutos.
- Casos de uso comuns: Monitoramento de preços, dados de produtos de e-commerce, anúncios imobiliários, vagas de emprego, registros jurídicos, geração de leads e preparação de conjuntos de dados para modelos de linguagem de grande escala.
- Serviços gerenciados: Para necessidades complexas ou de alto volume, o Browse AI oferece web scraping totalmente gerenciado e serviços corporativos, organizados por meio de uma consulta com a equipe de vendas.
Para Quem É
O Browse AI atende qualquer pessoa que precise de dados da web recorrentes, mas não possa ou não queira escrever código de scraping. Os usuários típicos incluem equipes de e-commerce e precificação que acompanham preços e estoques de concorrentes, analistas imobiliários que monitoram anúncios, recrutadores e equipes de RH que examinam sites de vagas, pesquisadores jurídicos que acompanham dados de casos e profissionais de vendas ou marketing que constroem listas de leads. Também atende equipes de dados e engenharia que desejam transformar sites em APIs ou pipelines que alimentam planilhas, bancos de dados ou aplicações baseadas em LLMs, além de empresas com necessidades em larga escala atendidas por meio de seus serviços de scraping gerenciado.