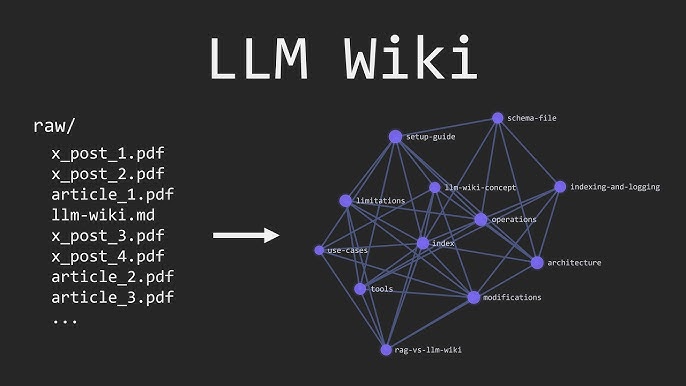
Numa era de sobrecarga de informação, o cérebro deve deixar de ser um contêiner de conhecimento e se tornar um conector dele. Quando a IA é seu copiloto cognitivo, como fazer seu segundo cérebro funcionar de forma integrada com ela?
Por que um segundo cérebro compatível com IA?
O conceito tradicional de segundo cérebro — popularizado pelo método PARA de Tiago Forte e pela metodologia Building a Second Brain — enfatiza a gestão do conhecimento pessoal: capturar, organizar, destilar, expressar. Na era da IA, o conceito precisa evoluir. Não estamos mais construindo uma base de conhecimento apenas para nós; estamos construindo um ecossistema de conhecimento colaborativo humano-máquina. Um segundo cérebro compatível com IA permite que a IA entenda, acesse e use efetivamente seus ativos de conhecimento — enquanto você mantém a soberania sobre eles.
A mudança central: de legível por humanos para legível por humanos e máquinas
As bases de conhecimento pessoais tradicionais funcionam com texto livre, notas espalhadas e árvores de pastas. Esse conteúdo é significativo para humanos — “eu sei onde guardei aquele arquivo” — mas para a IA é névoa semântica. O design compatível inverte cinco hábitos:
| Tradicional | Compatível com IA |
|---|---|
| Parágrafos narrativos longos | Unidades estruturadas e atômicas |
| Associações implícitas | Links explícitos e relações tipadas |
| Tags em formato livre | Taxonomias semanticamente consistentes |
| Formato único de texto | Multimodal com metadados |
| Recuperação por memória | Recuperação por programa |
O princípio norteador: tornar seu conhecimento compreensível por humanos — e vetorizável, indexável e semanticamente pesquisável por máquinas.
As cinco camadas de um segundo cérebro compatível com IA
Camada 1: Unidades de conhecimento atômicas
Cada nota expressa exatamente um conceito, fato ou ideia, com tamanho entre aproximadamente 100 e 300 palavras. O contraste:
❌ Ruim:
"Notas da reunião sobre segundo cérebro com IA — discutimos RAG,
grafos de conhecimento, escolha de modelos de embedding,
privacidade de dados, e o almoço estava bom..."

✅ Bom:
Título: "Definição de RAG (Retrieval-Augmented Generation)"
Corpo: RAG é uma arquitetura que combina recuperação de informação e
geração de texto...
Relacionado: [[Embedding]], [[Banco de dados vetorial]], [[Janela de contexto]]
Por que a IA se importa: unidades atômicas são vetorizadas de forma limpa, fragmentadas com precisão e recuperadas com acurácia.
Camada 2: Arquitetura de metadados semânticos
Atribua três níveis de metadados a cada unidade:
---
title: "Definição de RAG"
type: concept
created: 2025-01-15
domain: ai-architecture
confidence: high
related: ["Embedding", "Vector database"]
difficulty: intermediate
---
Por que a IA se importa: metadados estruturados permitem recuperação condicional, filtragem e raciocínio sobre seu corpus.
Camada 3: Links explícitos de grafo de conhecimento
Pare de depender apenas de pastas e tags; construa links explícitos bidirecionais: [[Conceito A]] aponta para [[Conceito B]], com anotações tipadas como [[Artigo X]] ->(rebate) [[Artigo Y]]. Obsidian, Roam Research e Logseq suportam nativamente esse formato. Por que a IA se importa: relações de links são interpretadas como estruturas de grafo, suportando recuperação por caminhos e raciocínio relacional.
Camada 4: Uma interface de consulta executável
Um segundo cérebro compatível com IA não deve ser um arquivo estático. Ele deve expor: uma API de busca semântica (via embeddings); consultas por intervalo de tempo; recuperação por relevância conceitual; e consultas de delta — “que conhecimento novo sobre X chegou na última semana?” Construa sobre a API do Notion, Obsidian Publish com um Cloudflare Worker, ou um banco de dados vetorial local como Chroma ou Qdrant. Por que a IA se importa: a máquina deve acessar seu conhecimento programaticamente, não “folheando notas” em conversa.
Camada 5: Fluxos de trabalho colaborativos com IA
Integre a IA nas duas pontas do ciclo de conhecimento:
Fluxo de entrada:
info bruta → resumo pela IA → extração de conceitos atômicos → link
com conhecimento existente → armazenamento

Fluxo de saída:
intenção de consulta → IA recupera unidades relevantes → organização
da estrutura → geração de rascunho → revisão humana
Na prática: use IA para resumir notas automaticamente, detectar duplicatas e sugerir links faltantes. Por que a IA se importa: a IA não é espectadora do seu conhecimento — é participante do ciclo.
Uma arquitetura mínima viável
Stack de ferramentas recomendado
| Camada | Recomendado | Alternativas |
|---|---|---|
| Edição de notas | Obsidian | Logseq, Anytype |
| Links bidirecionais | Obsidian nativo | Roam Research |
| Gestão de metadados | YAML frontmatter | Plugin Dataview |
| Armazenamento vetorizado | Obsidian Copilot + embeddings locais | Notion + Make.com |
| Interface de consulta com IA | LangChain + banco vetorial local | Flowise, Dify |
| Visualização de grafo | Obsidian Graph | Neo4j (em larga escala) |
Estrutura de diretórios (PARA simplificado)
SecondBrain/
├── 00_Inbox/          # capturas brutas
├── 10_AtomicNotes/    # conhecimento atômico, por domínio
│   ├── ai/
│   ├── productivity/
│   └── personal/
├── 20_Concepts/       # cartões de conceitos
├── 30_Relations/      # mapas de relações (MOCs - Maps of Content)
├── 40_Projects/       # conhecimento de projetos
└── 50_Archives/       # arquivo morto
O checklist semanal de compatibilidade com IA
- As novas notas foram divididas em granularidade atômica?
- Cada nota tem metadados YAML?
- Os
[[links bidirecionais]]foram estabelecidos? - A IA consegue encontrar os conceitos-chave via busca semântica?
- Algum conhecimento ainda vive apenas na minha cabeça?
Armadilhas: três erros e suas correções
Armadilha um: estruturar demais. O problema — gastar 80% do tempo mantendo metadados e links em vez de criar conhecimento. A correção — aceitar “bom o suficiente”; anote apenas os campos que a recuperação pela IA realmente precisa, e deixe a IA sugerir automaticamente os metadados e os links.
Armadilha dois: uma stack de ferramentas pesada demais. O problema — construir um sistema elaborado e abandoná-lo três dias depois. A correção — comece com Markdown em texto simples no Obsidian, e só considere um banco de dados vetorial após duas semanas de uso contínuo.
Armadilha três: ignorar os limites da IA. O problema — esperar que a IA entenda perfeitamente suas metáforas, humores e contexto implícito. A correção — mantenha o conhecimento decisivo e o conteúdo altamente pessoal em formatos exclusivamente humanos; a camada compatível com IA é para o conhecimento que pode ser expresso explicitamente.
Perspectiva: ativos de conhecimento interoperáveis
À medida que os modelos de IA evoluem, o segundo cérebro compatível com IA crescerá de uma ferramenta pessoal para a base de um protocolo de ativos de conhecimento: formatos padronizados de troca de conhecimento (RDF para grafos de conhecimento, GQL para grafos de propriedades); espaços pessoais de conhecimento interoperáveis, nos quais os segundos cérebros de pessoas diferentes podem colaborar com segurança; e delegação de conhecimento entre agentes de IA — “verifique tudo no meu segundo cérebro sobre X.” Estamos migrando de possuir conhecimento para conhecimento que a IA pode invocar.
Conclusão: seu cérebro é o comandante, não o armazém
Construir um segundo cérebro compatível com IA é, em essência, redefinir a divisão cognitiva do trabalho entre humanos e máquinas. Os humanos ficam com as boas perguntas, as conexões criativas e os juízos de valor. O segundo cérebro fica com o armazenamento confiável, a gestão estruturada e a recuperação rápida. A IA fica com a compreensão semântica, o reconhecimento de padrões, a geração de conteúdo e as sugestões de relações. Os três formam um ciclo fechado: você não precisa lembrar de tudo nem organizar tudo manualmente — precisa projetar uma arquitetura de conhecimento que permita à IA colaborar efetivamente.
Comece hoje: escolha três notas, adicione metadados YAML e links bidirecionais. Seu parceiro de IA vai agradecer.
Este artigo faz parte da série LLM-WIKI, dedicada a construir estruturas de conhecimento compartilhadas entre humanos e IA. Próximo da série: “De Notas a Grafos de Conhecimento: Aprimorando Seu Segundo Cérebro com Bancos de Dados Vetoriais.”
