Comece Pelo Modelo Mental Certo
A TypeSafe lançou o Jev em 15 de setembro de 2026, e a proposta parece contraditória: é um modelo de IA que não gera nenhum texto. Chame-o de Modelo do Sistema Um — uma referência deliberada a Kahneman. Onde um LLM de raciocínio é o Sistema Dois, lento e caro, o Jev é reconhecimento de padrões rápido e barato.
Os números oficiais ilustram a diferença: uma única decisão custa US$ 0,000081 e é concluída em 0,114 segundos. Um LLM típico fazendo a mesma classificação custa US$ 0,01388 e leva 8,566 segundos. Isso representa duas ordens de magnitude em custo e aproximadamente 80 vezes em velocidade.
Antes de continuar a leitura, audite seu pipeline em busca de julgamentos de alta frequência: priorizar este ticket, encaminhar este e-mail, aprovar esta chamada de ferramenta. Se eles existem, o Jev deve entrar na sua lista de candidatos. Se cada etapa exige geração de texto longo, não deve.
O Fluxo de Trabalho: Respostas Tipadas, Não Prosa
A superfície da API é propositalmente pequena. Você envia duas coisas: um state (texto livre ou JSON arbitrariamente aninhado — um ticket, um pedido, um registro de conta) e uma lista de questions sobre esse estado.
O que volta não é prosa. Cada pergunta retorna uma resposta tipada com uma distribuição de probabilidade e uma pontuação geral de confiança. Seu código faz um desvio com um if baseado em um número — não há etapa de parsing de saída e nem modo de falha por JSON malformado. É isso que o “type-safe” lhe garante.
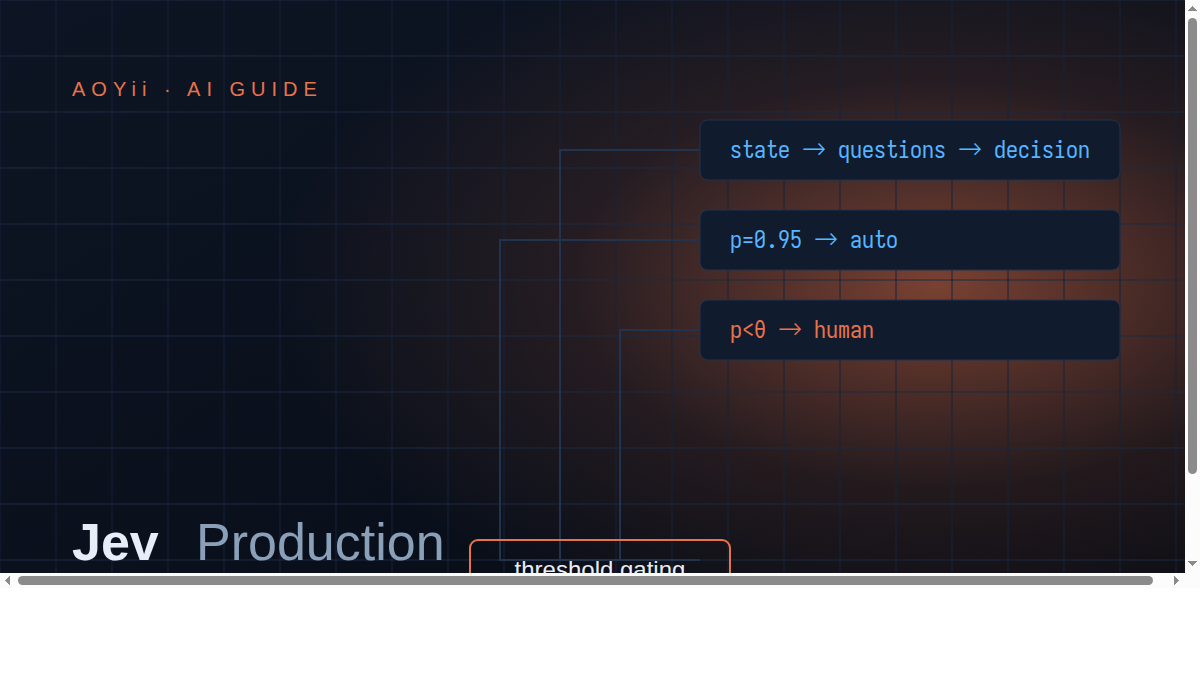
O ciclo completo tem quatro estágios: estado entra, perguntas avaliadas em paralelo, respostas tipadas com confiança saem, e seu software faz o roteamento com base em limiares. Acima do limiar, executa automaticamente; abaixo dele, escala para um humano. Adicionar mais perguntas ao mesmo estado quase não adiciona latência, então é normal fazer três ou quatro perguntas de uma vez.
Um exemplo prático da documentação oficial: um ticket de suporte cujo estado inclui ticket.message (“callback de pagamento do Stripe falhando há 3 dias”), o registro do pedido e o texto da política de reembolso. Três perguntas rodam em paralelo — é urgente, qual equipe deve assumir, quão frustrado está o cliente — e todas as três respostas chegam em uma única ida e volta.
Desenhando Perguntas: Três Tipos, Uma Regra
O Jev suporta três tipos de pergunta, e o segredo está em como você escreve os critérios.
Noul (julgamento sim/não) retorna a probabilidade de uma afirmação ser verdadeira. Use para urgência, conformidade, sinais de risco. O erro capital é perguntar “Isso é urgente?” — urgência é indefinida, então a probabilidade é ruído. Incorpore o padrão aos critérios: impacta produção, tem mais de 24 horas, ou envolve dinheiro. Quanto mais específicos os critérios, mais confiável a probabilidade.
Choice (múltipla escolha) retorna uma probabilidade por opção mais a confiança. Este é seu primitivo de roteamento: faturamento, conta ou técnico? Você recebe uma distribuição como faturamento 0,8 e conta 0,15. Pegue o argmax, ou roteie para um humano quando as duas primeiras opções estiverem estatisticamente próximas.
Score (escala) retorna uma pontuação, uma distribuição e a confiança. Frustração avaliada de 0 a 2 pode vir como 1,04 com uma dispersão de 0,94. Leia a forma da distribuição, não apenas a média — uma distribuição bimodal está dizendo algo que um único número esconde.
Três hábitos que valem a pena cultivar: escreva critérios como um documento de política, sature cada estado com perguntas em paralelo e trate as distribuições como saída de primeira classe.
A Matemática do Preço
Na OpenRouter, typesafe/jev-1.13 custa US$ 0,042 por milhão de tokens de entrada; a saída é gratuita. Isso dá cerca de 240 decisões de pergunta única por centavo.
O contexto importa mais do que o número bruto. Benchmarks da comunidade: revisão de pull-request a cerca de US$ 1 por 70.000 decisões — 1.000 PRs por 7 centavos contra US$ 14,50 no Claude Opus. Um agente de navegador completou um fluxo completo de reserva de voos em 7 segundos. Um agente que joga Doom tomou 10 decisões por segundo.
A mudança econômica é arquitetural. Quando o custo marginal do julgamento se aproxima de zero, você para de fazer amostragem e cache e passa a avaliar cada evento. Isso desbloqueia produtos que antes eram inviáveis financeiramente — pontuação por evento, checagens de segurança por chamada de ferramenta, triagem por mensagem.
Uma ressalva: saída gratuita e entrada barata cheiram a preço subsidiado. Modele seus custos de longo prazo com um aumento de preço de 5 a 10 vezes antes de arquitetar qualquer coisa crítica em cima disso.
Quatro Caminhos de Integração
Cloudflare Workers AI (ID do modelo typesafe/jev, contexto de 32K) atende equipes que já estão no edge da CF e querem baixa latência. A demo oficial de tickets roda aqui: urgência 0,95, roteamento para faturamento a 0,8, frustração 1,04/0,94 — e um estado separado de problema de login roteado para conta com confiança de 1,0.
OpenRouter (typesafe/jev-1.13, com um alias jev-latest que acompanha a versão mais recente) é a forma mais rápida de validar. Uma requisição HTTP, sem lock-in de infraestrutura, e comparações de custo lado a lado fáceis contra seu LLM atual.
LangChain via o pacote langchain-typesafe é a integração mais rica, com três modos de middleware:
TypeSafeClassifier— o classificador básico. O estado pode ser texto simples, dados estruturados ou objetos de mensagem do LangChain. Encaixe-o em uma chain existente como um nó de julgamento.ModelRouterMiddleware— roteamento baseado em dificuldade que envia cada requisição ao modelo mais barato capaz de lidar com ela. Chamadas triviais vão para o Jev; raciocínio genuíno escala para um LLM. Este é o padrão de economia de custo mais direto.AutoModeMiddleware— uma salvaguarda inspirada nas camadas de segurança do Claude, Codex e Cursor. Antes de ferramentas de alto risco como o bash executarem, o Jev avalia o perigo e bloqueia se exceder o limiar. O resumo em uma linha: use um modelo do Sistema Um para segurar seu modelo do Sistema Dois.
O console oficial em console.typesafe.ai está em acesso antecipado — útil para prototipar critérios em uma UI antes de escrever código.
Caminho sugerido: prototipe na OpenRouter, depois escolha Workers AI ou LangChain para produção dependendo do formato da sua implantação. O trio de middlewares do LangChain é atualmente a superfície de integração mais completa.
Um Rollout em Três Passos
Passo 1: Verifique a calibração antes de confiar em qualquer coisa. Pegue 100–500 tickets históricos (ou julgamentos reais equivalentes do seu domínio), rotule-os à mão e rode um teste de regressão contra o Jev. Não meça apenas a precisão média — verifique se as probabilidades são honestas. Quando o modelo diz 0,9, ele está certo cerca de 90% das vezes? Não há artigo publicado, contagem de parâmetros ou estudo de ablação para se apoiar, então esse teste é a única evidência que conta.
Passo 2: Comece em território de baixo risco. Triagem de e-mails, roteamento de tickets, marcação de conteúdo — lugares onde uma decisão errada custa segundos de tempo humano, não dólares. O tráfego real aqui ensina como a confiança do Jev se comporta na prática, e você aperta os limiares conforme as evidências se acumulam.
Passo 3: Adicione salvaguardas de agente por último. Quando tiver dados de calibração e experiência de baixo risco em mãos, acople o AutoModeMiddleware às ferramentas perigosas para que toda execução de bash passe por uma checagem de risco primeiro. Inverter a ordem — salvaguardas antes da calibração — é instalar ABS num carro com freios não testados.
Limitações e Pegadinhas
- Ele vai errar às vezes. Saída probabilística exige limiares e um fallback humano. Não existe modo de automação de 100%.
- “Zero alucinação” significa type-safe, não correto. O formato da saída é sempre parseável; o julgamento dentro dela ainda pode estar errado. Mantenha essas duas alegações separadas.
- Teto de contexto de 32K. Documentos longos precisam de chunking ou sumarização antes, e a qualidade do julgamento é sensível a quão densa em informação é o seu estado.
- Sem entrada de imagem. Apenas texto e JSON; necessidades multimodais exigem outra ferramenta.
- Raciocínio matemático é aproximadamente nível GPT-4. Raciocínio profundo ainda pertence a um modelo do Sistema Dois.
- O preço pode ser subsidiado. Faça um teste de estresse na sua economia unitária com preços mais altos.
- Sem artigo publicado nem ablações. Os benchmarks oficiais são um ponto de partida, nunca um substituto para validação nos seus próprios dados.
- O ecossistema é jovem. SDKs e boas práticas ainda estão mudando; mantenha seu próprio wrapper enxuto para poder trocar de provedor barato.
A reflexão final: o valor do Jev não é substituir seu LLM. É converter as etapas de julgamento que eram caras demais para um LLM e rígidas demais para regras escritas à mão em uma função de probabilidade programável. Valide a calibração nos seus próprios dados primeiro — depois escale.
