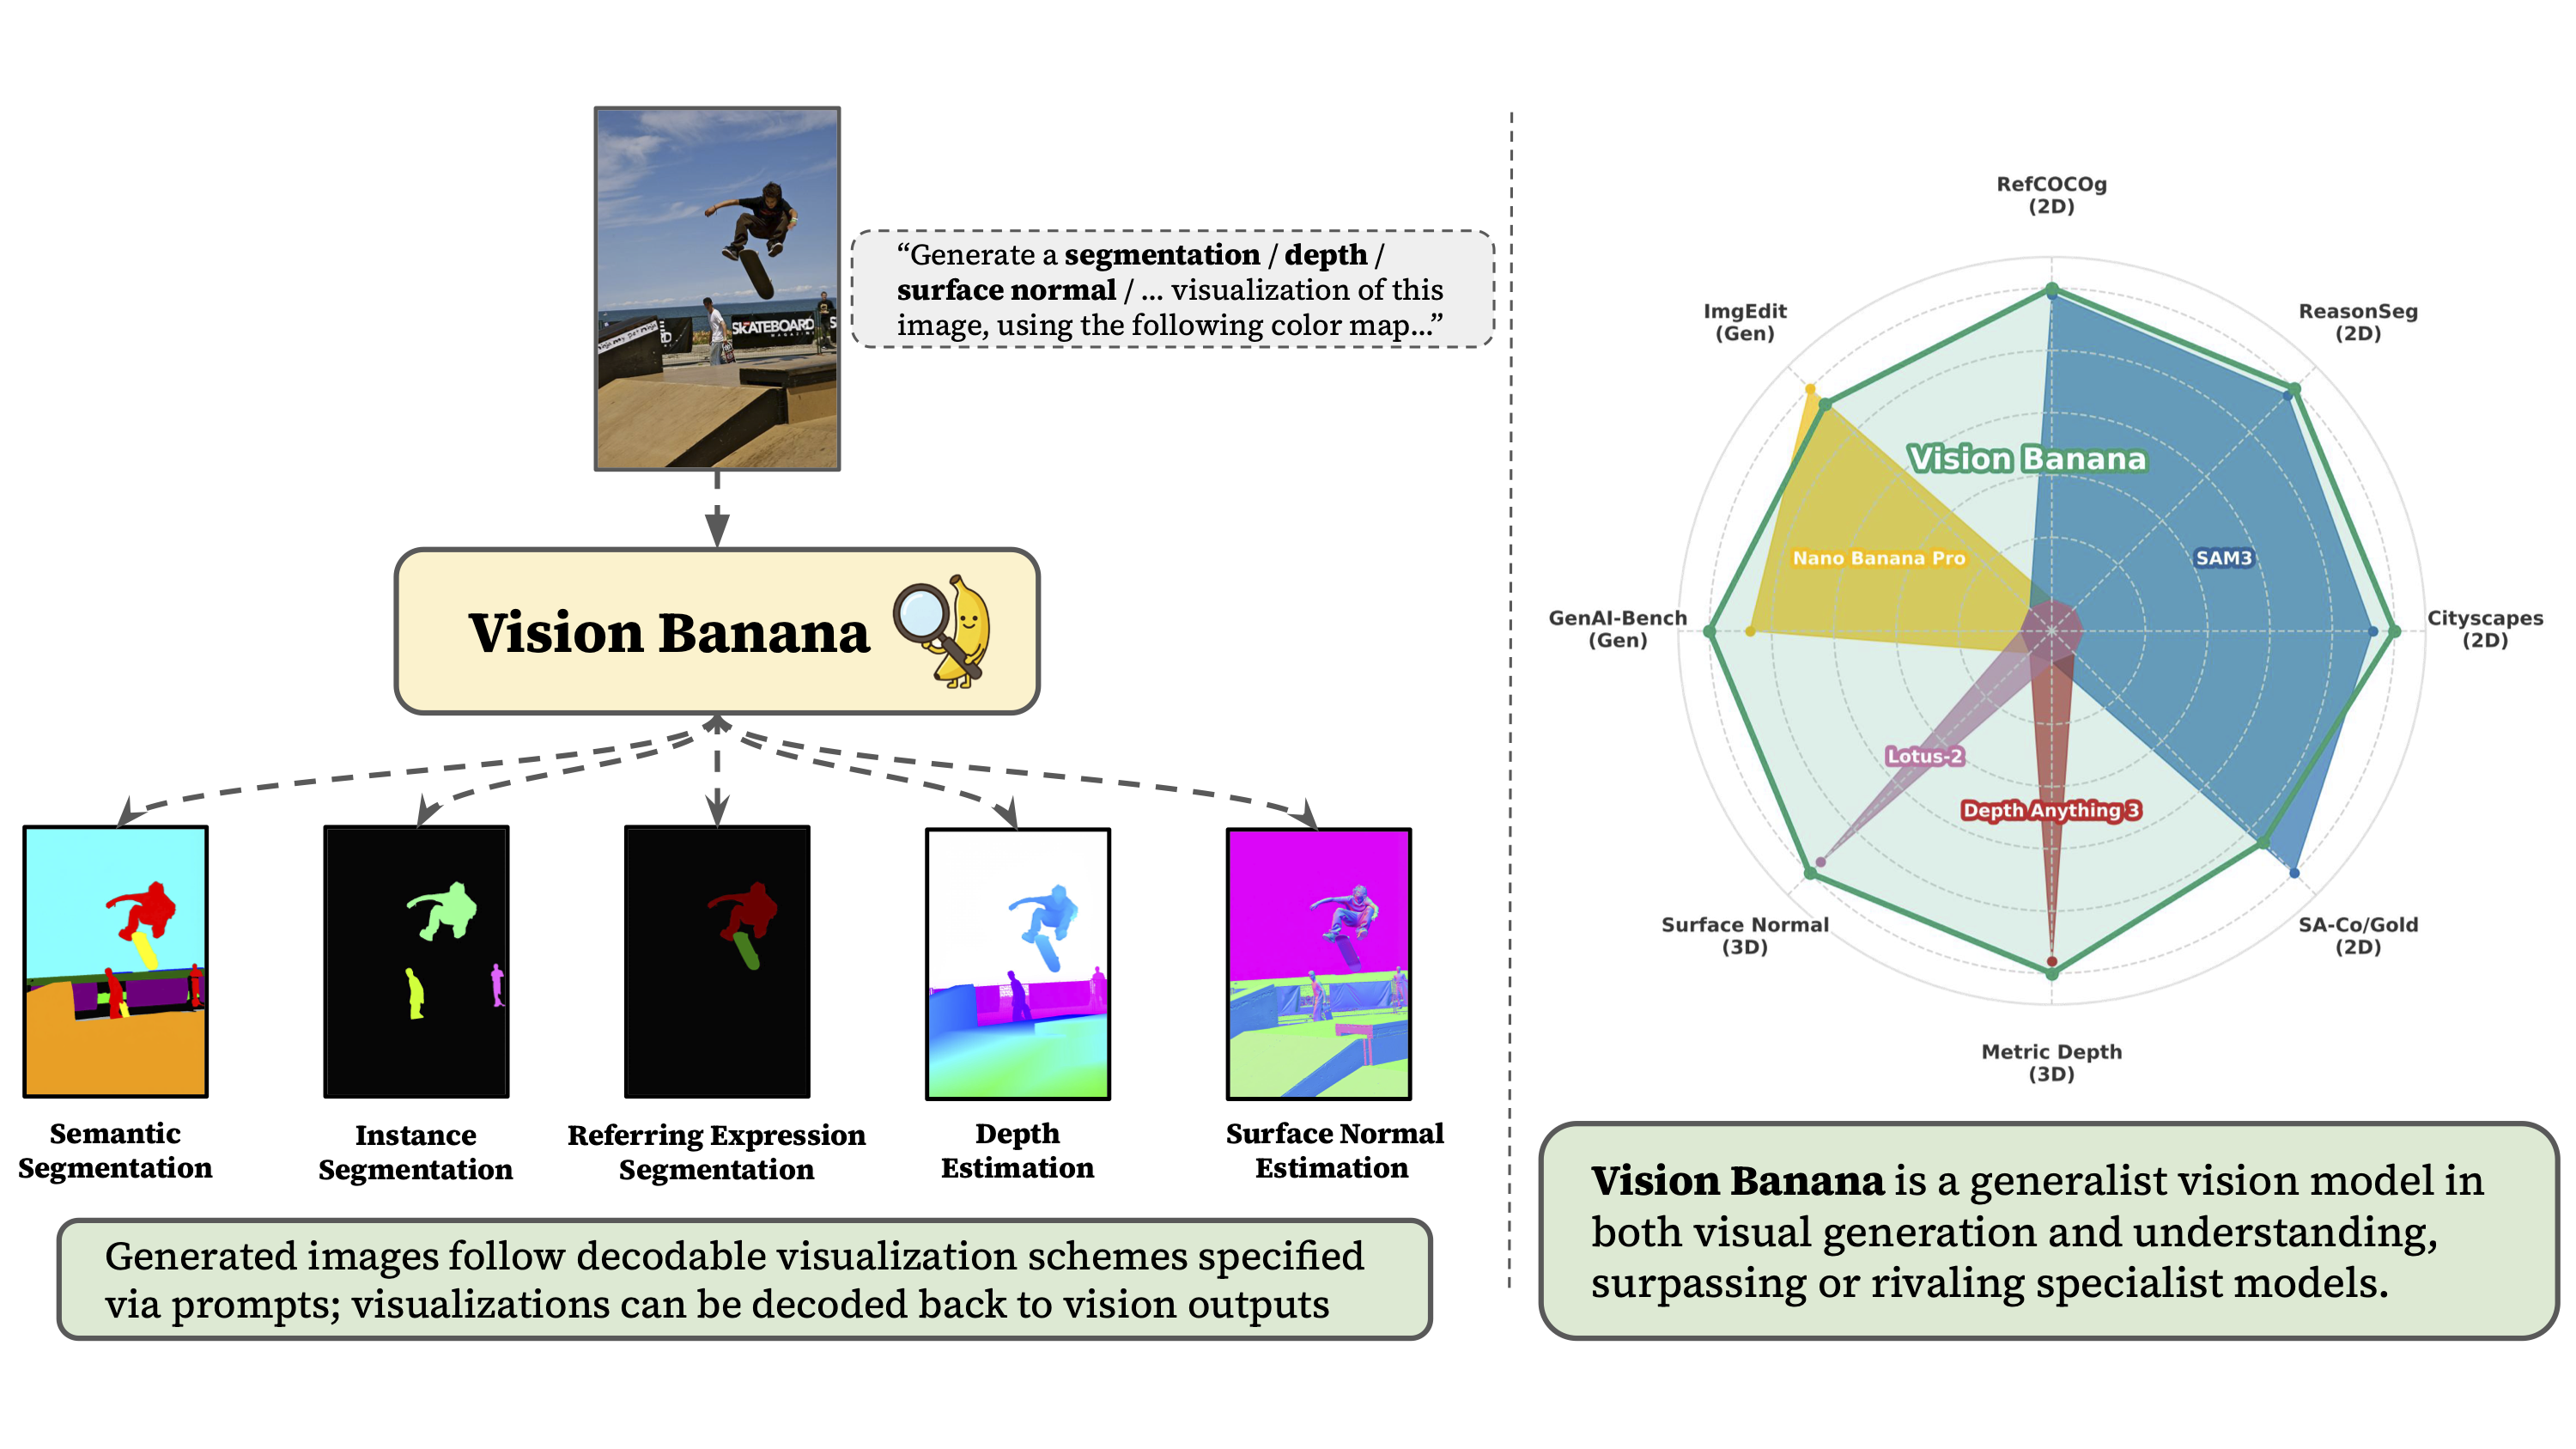
Por anos, a visão computacional trilhou dois caminhos separados: modelos generativos, que criam imagens, e modelos discriminativos, que as entendem. A suposição consagrada da indústria — um modelo que pinta bem não necessariamente lê bem — acaba de ser derrubada. Em 22 de abril de 2026, a equipe do Google DeepMind publicou um artigo intitulado Image Generators are Generalist Vision Learners, apresentando o Vision Banana: um modelo de visão generalista unificado que iguala ou supera sistemas especialistas de ponta em segmentação semântica, segmentação de instâncias, estimativa de profundidade métrica monocular e estimativa de normais de superfície — tudo isso mantendo sua capacidade original de geração de imagens intacta.
A Ideia Central: A Analogia com os LLMs, Transplantada para a Visão
Qualquer pessoa que conhece modelos de linguagem de grande escala conhece a receita de duas etapas: pré-treinamento generativo em vastas quantidades de texto e, depois, ajuste por instruções para se adaptar a tarefas downstream. O pré-treinamento constrói representações internas ricas que transferem para quase tudo. A afirmação central da equipe do Google: o treinamento de geração de imagens desempenha exatamente o papel que o pré-treinamento de LLMs desempenha para a linguagem. O modelo base deles, o Nano Banana Pro (NBP), é o gerador de imagens mais avançado do Google. Ao misturar uma pequena proporção de dados de tarefas de visão computacional à dieta original de treinamento do NBP e rodar um ajuste leve por instruções, eles produziram o Vision Banana.
A percepção-chave: gerar imagens fotorrealistas requer implicitamente compreender geometria, semântica, profundidade e relações entre objetos. O Vision Banana aprende a expressar esse conhecimento latente em formatos mensuráveis e decodificáveis. E, crucialmente, os dados de ajuste por instruções não contêm nenhum dado de treinamento dos benchmarks de avaliação — cada resultado reportado reflete generalização genuína, não memorização dentro do domínio.
Como Funciona: Percepção como Geração de Imagens
O Vision Banana não adiciona cabeças decodificadoras especializadas nem módulos de regressão. Em vez disso, toda saída de tarefa de visão é parametrizada como uma imagem RGB: o modelo ajustado por instruções produz visualizações seguindo esquemas de cores precisos e invertíveis, o que significa que as imagens geradas podem ser decodificadas de volta em saídas quantitativas para pontuação nos benchmarks. A equipe identifica três vantagens dessa estratégia. Um modelo unificado atende a muitas tarefas — após o ajuste por instruções, trocar de tarefa muda apenas o prompt, nunca os pesos. É eficiente em dados, porque o ajuste por instruções ensina principalmente o modelo a formatar as saídas de CV como RGB. E preserva a capacidade de geração, já que a saída de uma tarefa é apenas outra imagem RGB.
As Tarefas, Concretamente
Segmentação semântica: o modelo recebe uma instrução como “gere a visualização de segmentação desta imagem usando o mapeamento de cores: gato vermelho, fundo amarelo”. Cada pixel é colorido pela classe prevista e, como a atribuição de cores está no prompt, não é necessário um vocabulário fixo de rótulos.
Segmentação de instâncias: o número de instâncias é desconhecido, então o Vision Banana usa inferência por classe — uma passagem por classe, atribuindo dinamicamente a cada instância uma cor única e, depois, recuperando as máscaras agrupando pixels de cores semelhantes.
Estimativa de profundidade métrica: um mapeamento bijetivo comprime valores de profundidade ilimitados [0, ∞) em RGB limitado [0,1]³. Uma transformação de potência (forma λ = -3, escala c = 10/3) primeiro curva os valores de profundidade e depois os codifica como uma visualização em pseudo-cores que percorre as arestas do cubo RGB ao longo de uma curva de Hilbert 3D. A transformação é estritamente invertível, então as imagens de profundidade geradas são decodificadas de volta com precisão para distâncias físicas. Notavelmente, nenhum parâmetro de câmera — intrínseco ou extrínseco — é necessário no treinamento ou na inferência: o modelo infere a escala absoluta a partir de pistas visuais e do conhecimento de mundo embutido durante o pré-treinamento, e os dados de treinamento de profundidade são inteiramente sintéticos, renderizados por motores de simulação com zero dados reais de profundidade.
Estimativa de normais de superfície: o mapeamento é quase gratuito — as normais de superfície são vetores unitários (x, y, z) em [-1, 1], o que se mapeia naturalmente nos canais RGB. Normais voltadas para a esquerda codificam rosa; normais voltadas para cima, verde-claro; normais voltadas para a câmera, azul-arroxeado claro.
Superando os Especialistas, em Números
Todos os resultados são de transferência zero-shot — o modelo nunca viu nenhum dado de treinamento dos conjuntos de avaliação:
Compreensão semântica 2D: segmentação semântica no Cityscapes val — mIoU de 0.699 contra 0.652 do SAM 3, uma vantagem de 4.7 pontos. Segmentação referida no RefCOCOg UMD val — cIoU de 0.738, superando por pouco os 0.734 do SAM 3 Agent. Segmentação por raciocínio no ReasonSeg val — gIoU de 0.793, batendo os 0.770 do SAM 3 Agent e até superando métodos non-zero-shot treinados com dados do próprio domínio. Segmentação de instâncias no SA-Co/Gold — pmF1 de 0.540, empatando com o DINO-X (0.552) e claramente à frente do Gemini 2.5 (0.461), APE-D (0.369) e OWLv2 (0.420).
Compreensão estrutural 3D: profundidade métrica — δ1 médio de 0.882 em seis grandes benchmarks; nos quatro conjuntos de dados avaliados pelo Depth Anything V3 (NYU, ETH3D, DIODE-Indoor, KITTI), o Vision Banana marca 0.929 contra 0.918 — sem nenhum dado real de treinamento e nenhum parâmetro de câmera. Normais de superfície — erro angular médio de 18.928° em quatro conjuntos de dados contra 19.642° do Lotus-2; nos conjuntos de dados internos (indoor), registra o menor erro angular médio (15.549°) e mediano (9.300°) entre todos os métodos comparados.
Geração preservada: em benchmarks generativos, o Vision Banana é estatisticamente indistinguível do seu modelo base — taxa de vitória de 53,5% sobre o Nano Banana Pro no GenAI-Bench (texto-para-imagem) e 47,8% competitivos no ImgEdit (edição de imagens, contra os 52,2% do NBP). O ajuste leve por instruções não prejudica a geração.
As Conclusões
- O pré-treinamento de geração de imagens produz aprendizes visuais generalistas. Assim como o pré-treinamento de LLMs desbloqueou compreensão emergente da linguagem, o treinamento em geração de imagens desenvolve naturalmente representações visuais internas que transferem para segmentação, profundidade e normais.
- Não é preciso arquitetura especialista para vencer modelos especialistas. Um ajuste leve por instruções do Nano Banana Pro supera o SAM 3 em três benchmarks de segmentação, o Depth Anything V3 em profundidade métrica (δ1: 0.929 vs 0.918) e o Lotus-2 em normais — tudo em regime zero-shot.
- Toda tarefa de visão se torna geração de imagens. Parametrizar saídas de tarefas como RGB decodificável significa um único conjunto de pesos e troca apenas por prompt entre segmentação, profundidade e normais — sem módulos específicos por tarefa.
- Profundidade métrica sem câmeras nem dados reais. A transformação de potência bijetiva mapeia profundidade no espaço de cores RGB; a escala absoluta vem apenas do contexto visual, e os dados de treinamento são puramente sintéticos.
- Geração de imagens como interface universal da visão. Assim como a geração de texto unificou as tarefas de linguagem, a geração de imagens pode se tornar a interface de saída universal para a visão computacional.
O Sinal de Mudança de Paradigma
O Vision Banana pode marcar uma verdadeira mudança de paradigma na visão computacional. Assim como a geração de texto se tornou a interface unificadora para compreensão e raciocínio de linguagem, a geração de imagens pode se tornar a interface universal para compreensão visual — um pré-treinamento visual generativo construindo um único modelo de fundação que tanto cria quanto compreende. Na prática, isso sugere um futuro em que ninguém treina um modelo especialista por tarefa de visão; você faz o ajuste por instruções de um único gerador unificado. Filosoficamente, responde a uma questão antiga — se geração e compreensão são fundamentalmente relacionadas — com um sonoro sim: um modelo capaz de criar conteúdo visual necessariamente também o entende.
Artigo: arXiv:2604.20329. Página do projeto: vision-banana.github.io. Fonte: Google DeepMind.

