一、它到底是什么:先纠正一个预期
2026 年 9 月中旬,TypeSafe 发布了一个叫 Jev 的 System One Model。名字里的「系统一」借自心理学:它不写文章、不写代码、不生成任何文本,只做一件事——快速给出判断。
传统 LLM 是系统二:慢、贵、擅长推理。Jev 是反过来的:快、便宜、擅长直觉式分类和评分。官方给的对比例子是单次决策 0.000081 美元、0.114 秒完成,对比典型 LLM 的 0.01388 美元、8.566 秒——成本差两个数量级,速度差近 80 倍。
所以第一步要想清楚:你的流水线里有没有「大量、高频、不需要长篇输出」的判断环节?客服工单该不该升级?这封邮件归哪个团队?这个工具调用危不危险?有,Jev 才值得看;没有,它帮不上忙。
二、工作流:state 进、类型化答案出
Jev 的 API 只有两个核心输入。第一个是 state:一段文本,或者任意嵌套的 JSON——可以是一张工单、一份订单、一条账户记录。第二个是 questions:你想对这份 state 提出的判断问题。
关键是输出不是自然语言,而是类型化结果:每个问题返回一个结构化答案,附带概率分布和整体置信度。你的代码拿到的是一个可以 if 判断的对象,不是一段要再解析的文本。这就是「类型安全」的含义——不存在幻觉输出格式错误的问题。
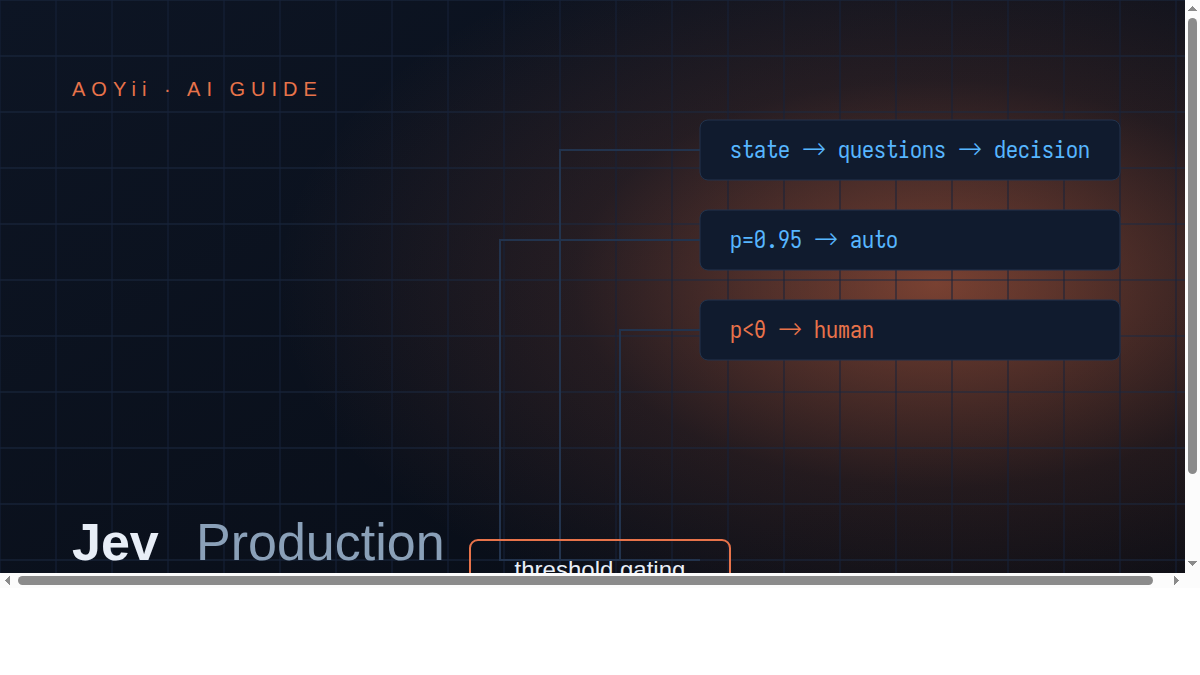
流程串起来是四步:state 进 → questions 并行提问 → 类型化答案加置信度 → 你的软件按预设阈值分流。超过阈值自动执行,低于阈值转人工。同一次 state 可以挂多个问题并行跑,官方口径是加问题几乎不增加延迟。
举个例子:一张客服工单,state 里放着 ticket.message(比如「Stripe 支付回调三天没成功」)加上订单信息和退款政策文本。三个问题同时问:这单紧急吗?该路由到哪个部门?用户沮丧程度打几分?——三个答案一次回来。
三、三种问题类型,criteria 怎么写
Jev 支持三种问题类型,各自对应不同判断形态。
Noul(是否判断):返回「为真」的概率。适合紧急性、合规性、是否存在风险这类二元问题。写的时候最忌讳只问「紧急吗?」——紧急的定义模糊,模型给的数就不可信。正确写法是把标准塞进 criteria:影响生产环境、响应超过 24 小时、涉及资金流动,满足才算紧急。判断标准越具体,返回的概率越有校准价值。
Choice(多选):返回各选项的概率和置信度。典型用途是路由——工单发给 billing、account 还是 technical?答案会告诉你 billing 0.8、account 0.15 这种分布,你可以直接取最大项,也可以在两个选项概率接近时设规则转人工。
Score(量表):返回分数加分布加置信度。适合情绪强度、满意度这类连续量。比如沮丧度 0 到 2 分,实际可能返回 1.04 / 0.94 这种带小数的分布——分布本身就是信息,比单点分数更值得利用。
三条设计原则:标准写具体;一个 state 榨干价值(并行多问);量表类问题优先看分布形态而不是只看均值。
四、定价账本:单次决策成本与高频经济学
官方价格(OpenRouter 口径):typesafe/jev-1.13,输入 0.042 美元每百万 token,输出免费。换算下来,一美分大约能跑 240 次单问题决策。对照基准是单次决策 0.000081 美元。
这个数字单独看没感觉,放进场景才有意义。社区实测的几组数据:
- PR 审核:大约 1 美元跑 7 万次,1000 个 PR 花 7 美分。同样的活用 Claude Opus 是 14.5 美元——差 200 倍。
- 浏览器自动订票全流程,7 秒。
- 一个 Doom 游戏里每秒做 10 次决策。
经济学逻辑是:高频 + 低单价的场景里,Jev 的边际成本趋近于零,你可以设计出「每个事件都判断一遍」的架构,而用 LLM 时你会本能地抽样、缓存、省着用。这会改变产品形态——不是优化旧流程,而是解锁原来因为太贵而不敢做的事。
但要留一个心眼:输出免费、输入极低,很可能是补贴性定价。算长期成本时按价格回升 5 到 10 倍做压力测试,确认商业模式仍然成立再深度绑定。
五、四条接入路径,怎么选
Cloudflare Workers AI:模型 ID 是 typesafe/jev,32K 上下文。适合已经在 CF 生态里、想要边缘部署低延迟的场景。官方示例就是在这条路径上跑的:工单 state + 三问并行,紧急度 0.95、路由 billing 0.8、沮丧度 1.04 / 0.94;另一类登录问题以 1.0 置信度直接路由到 account。
OpenRouter:typesafe/jev-1.13,另有 jev-latest 别名自动指向最新版。适合想先跑通、不想绑基础设施的团队。一条 HTTP 请求就能上手,也方便和现有 LLM 做成本对比测试。
LangChain(langchain-typesafe 包):这是集成价值最高的一条,提供三种中间件模式。
一是 TypeSafeClassifier,基础分类器,state 可以是纯文本、结构化数据或 LangChain 消息对象,适合给现有链路加一个判断节点。二是 ModelRouterMiddleware,按请求难度把任务分给「能胜任的最便宜模型」——简单判断交给 Jev,复杂推理才升级到 LLM,这是最直接的省钱模式。三是 AutoModeMiddleware,借鉴 Claude、Codex、Cursor 的工具护栏设计:bash 等高危工具执行前,先用 Jev 评估危险度,超标就拦截。这个模式的精髓一句话可以概括:用系统一模型给系统二模型上保险。
官方控制台(console.typesafe.ai):early access 状态,适合先在界面里试 criteria 设计,再落到代码。
选择建议:验证期用 OpenRouter,生产期按你的部署形态选 Workers AI 或 LangChain;LangChain 路径的三个中间件是当前最完整的集成模式。
六、落地三步:校准优先,风险递增
第一步:验证校准度,别信宣传。 拿 100 到 500 条历史工单(或你业务里的真实判断样本),人工标好正确答案,批量喂给 Jev 做回归测试。重点看的不是准确率均值,而是概率是否名副其实——标称 0.9 置信度的判断,实际是不是真的对 9 成。这一步不过关,后面全免谈。官方论文、参数规模、消融实验都没公开,这是唯一可信的验证方式。
第二步:低风险场景切入。 选错了有人兜底的场景:邮件分诊、工单路由、内容标签。这些地方 Jev 判断错了顶多多花几秒人工,你能在真实流量里积累对它置信度的手感,再逐步收紧阈值、扩大自动化比例。
第三步:上 Agent 护栏。 校准数据够了、低风险场景跑顺了,再把 AutoModeMiddleware 挂到 Agent 的高危工具上,让每次 bash 执行前都过一道危险度评估。这一步的前提是第二步已经给了你足够的阈值设定经验。
顺序不能倒:直接上护栏而不验证校准度,等于给刹车系统没测试过的车装 ABS。
七、局限与踩坑清单
- 判断会错。它有概率输出,就需要阈值设计和人工兜底,100% 自动化是不存在的。
- 「零幻觉」≠「判断正确」。类型安全保证的是输出格式永远可解析,不保证内容对。别把这两个概念混了。
- 32K 上下文上限。超长文档要先切片或摘要,判断质量对 state 的信息密度敏感。
- 无图像输入。纯文本和 JSON,多模态需求绕行。
- 数学推理约等于 GPT-4 水平。需要深度推理的场景还是要交给系统二模型。
- 价格可能是补贴价。长期成本建模时做涨价压力测试。
- 论文和参数未公开。官方口径只能参考,生产决策必须建立在自己数据的验证上。
- 生态很早期。SDK、社区方案、最佳实践都在快速变动,封装层自己留薄一点,方便换。
一句话收束:Jev 的价值不在替代 LLM,而在把你架构里那些「用 LLM 太贵、用规则太死」的判断环节换成一个可编程的概率函数。先用自己数据验校准,再谈规模化。