
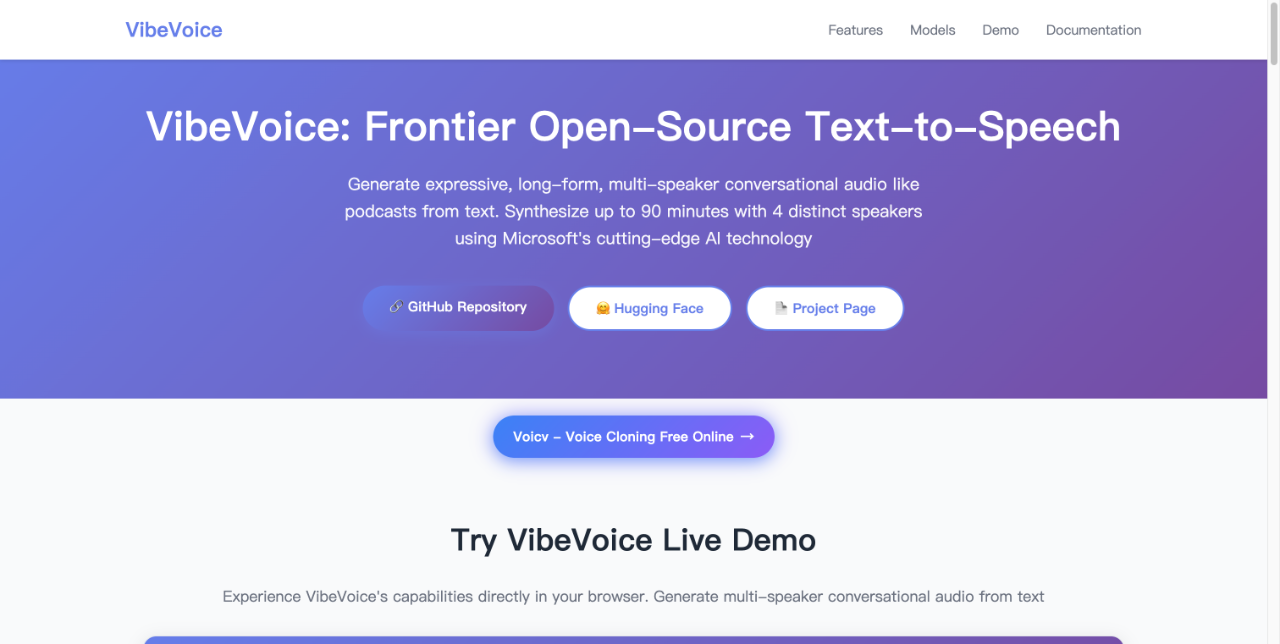
简介
欢迎来到VibeVoice,一个突破性的开源文本转语音(TTS)模型。它专为生成高质量、富有表现力的长篇多说话人对话音频而精心打造,旨在彻底改变播客、有声书和对话式内容的创作方式。
主要功能
多说话人对话生成:能够无缝地模拟多个独特的说话者声音,创造出自然流畅的对话体验。
长篇音频合成:针对播客、旁白等长篇内容进行了深度优化,确保音频的连贯性和稳定性。
丰富的表现力:模型能够捕捉并生成包含不同情感、语调和节奏的语音,让合成声音更具生命力。
开源与可定制:作为开源项目,开发者可以访问、使用并贡献代码,根据自己的需求进行定制和优化。
适用人群
- 内容创作者:如播客主、视频制作者,可以快速生成高质量的旁白或对话内容。
- 开发者和研究者:可以将其集成到自己的应用程序中或作为语音技术研究的基础。
- 教育机构和企业:用于制作培训材料、在线课程的有声内容,降低成本并提高效率。
- 无障碍服务倡导者:为视障人士或有阅读困难的人群将文本转换为更生动的语音。
相关教程
查看全部 →
相关工具
查看全部 → MiniMax 语音和音乐 MiniMax 提供基于先进AI技术的声音创作工具,支持多语种、情绪和效果定制。
 千音漫语 - AI配音 千音漫语是集智能配音、多语言翻译配音、声音克隆及语音识别于一体的AI声音创作平台,提供1200+AI主播和全球100多种语言支持,满足专业声音处理与短视频创作需求。
 Google Lyria 3 - 多模态音乐生成 🎧 Lyria 3 简介 Lyria 3 是由 Google DeepMind 推出的新一代 AI 音乐生成模型,专注于将文本、图像甚至视频转化为完整音乐作品。它结合了多模态理解与高保真音频生成能力,能够自动完成作曲、编曲、歌词与人声生成,是目前最接近“端到端音乐创作”的 AI 模型之一。 无论是内容创作者、开发者还是音乐制作人,都可以通过 Lyria 3 快速生成高质量音乐,用于视频、游戏、广告等多种场景。 主要功能 多模态音乐生成: 支持文 …
 LOVO - AI语音生成与文本转语音平台 提供500多种语音、支持100种语言的AI语音生成及文本转语音软件,含在线视频编辑器和声音克隆功能。
 ElevenLabs 提供支持32种语言的AI语音生成工具,具备可扩展的企业级解决方案和前沿文本转语音技术。