
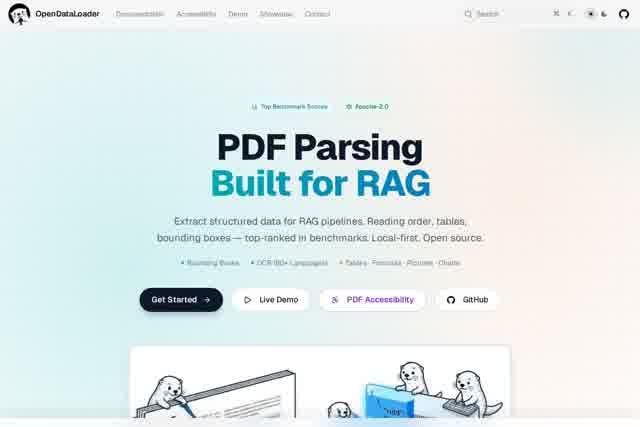
将PDF转换为LLM就绪的Markdown和JSON,支持边界框引用,自动标记未标记PDF为标记PDF,100%本地开源(Apache-2.0)。
最后更新 2026 年 9 月 4 日
简介
在人工智能与大语言模型(LLM)快速发展的今天,PDF文档的结构化解析已成为数据预处理的关键环节。OpenDataLoader PDF 是一款专为AI数据准备而生的本地开源PDF解析器,能够将PDF文件高效转换为LLM就绪的Markdown和JSON格式。该工具支持边界框引用,可自动将未标记的PDF转换为标记PDF,确保数据符合无障碍与可访问性标准。基于Apache-2.0开源协议,OpenDataLoader PDF 完全在本地运行,无需依赖云端服务,保障数据安全与隐私。
主要功能
**LLM就绪格式转换:**将PDF内容精准转换为Markdown和JSON格式,保留文档结构与层级关系,便于大语言模型直接读取与训练。
**边界框引用:**提取文本的同时记录每个元素的边界框坐标,支持精确的版面分析与内容定位,提升数据提取的准确性。
**自动标签化:**自动检测并为未标记PDF添加语义标签,生成符合无障碍标准的标记PDF,助力信息无障碍传播。
**100%本地化运行:**所有解析与转换过程均在用户本地设备完成,无需上传文件至云端,杜绝数据泄露风险。
适用人群
- **AI工程师与数据科学家:**需要将大量PDF文档快速转化为训练数据,构建RAG系统或微调LLM。
- **文档处理开发者:**希望集成PDF解析功能到本地应用,且对数据隐私有严格要求。
- **无障碍合规专员:**负责将未标记PDF转换为可访问格式,确保文档符合无障碍法规。
- **学术研究人员:**需要从论文、报告中提取结构化数据,用于文献计量或知识发现。
相关教程
查看全部 →
相关工具
查看全部 → 语析 Yuxi · 融合 RAG 与知识图谱的智能体 Harness 平台 | Yuxi - 智能体平台 语析 Yuxi 是一款融合 RAG 与知识图谱的智能体 Harness 平台,助力高效构建与部署智能应用。
 AI Mate AI Mate 是一款基于 OpenAI GPT-5 的智能助手,提供类人交互体验。
 9Router - Free AI Router | Smart Fallback for Claude, Codex 智能路由 Free AI routing with smart 3-tier fallback. Maximize subscriptions, auto-switch to cheap/free models. Never stop coding with Claude Code, Codex, Gemini CLI.
 OmniRoute — Free AI Gateway for Multi-Provider LLMs Free, open-source AI router with auto-fallback. 236 providers, one endpoint, 95 MCP tools, 17 routing strategies, A2A protocol, auto-combo engine, semantic cache, memory & skills. Deploy anywhere.
 AI检测局 AI检测局免费检测ChatGPT/Deepseek/文心一言/豆包/元宝/Qwen等AI生成文本内容,多个AI模型同时检测,速度快、准确率高。