
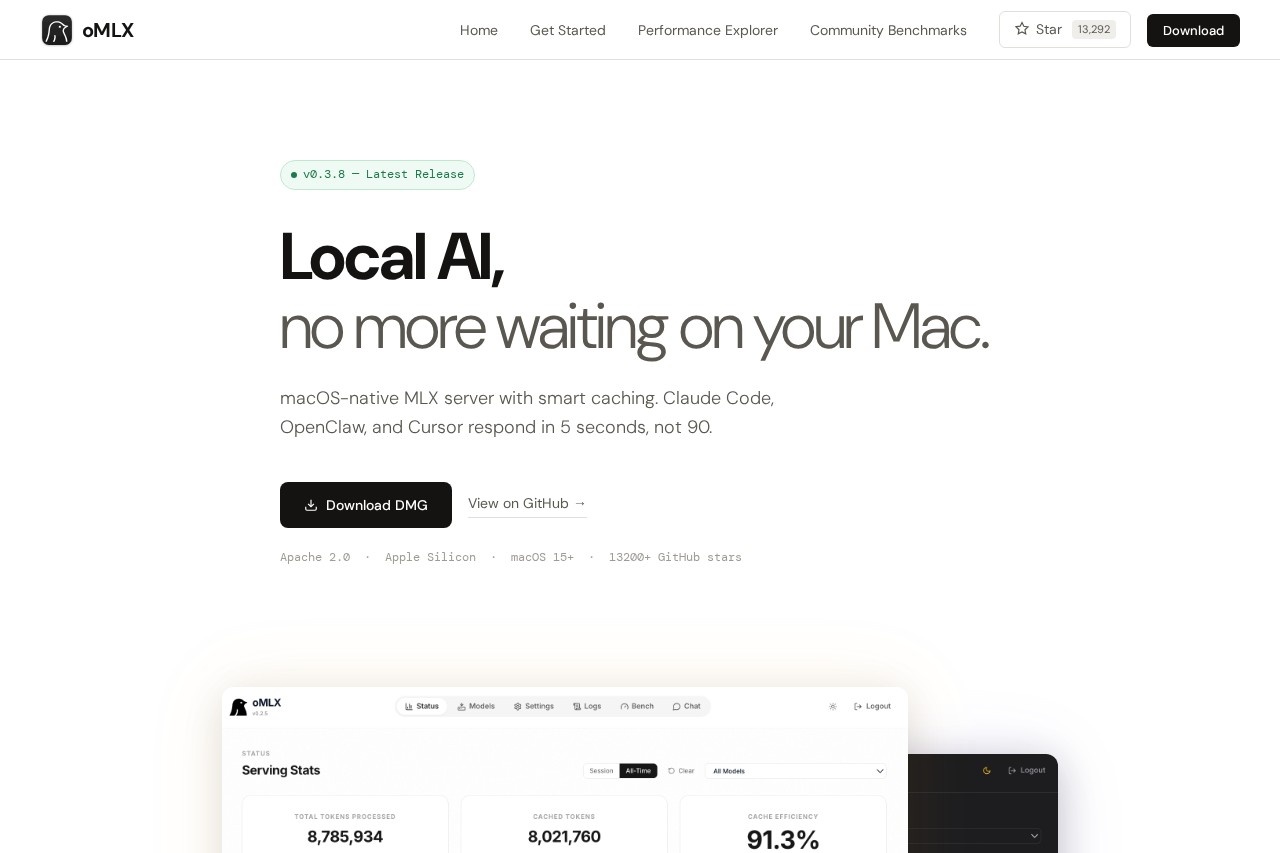
A native macOS inference server built on MLX. Paged SSD KV caching drops agent TTFT from 30-90s to under 5s. OpenAI & Anthropic compatible API for Apple Silicon.
最后更新 2026 年 11 月 10 日
简介
oMLX 是一款专为 macOS 设计的原生推理服务器,基于 Apple MLX 框架构建,旨在充分发挥 Apple Silicon 芯片的深度学习计算潜力。无论是运行大型语言模型(LLM)还是构建智能代理应用,oMLX 都能提供高效、低延迟的本地推理体验。通过创新的 Paged SSD KV 缓存技术,oMLX 将代理任务的首 token 生成时间(TTFT)从传统的 30-90 秒大幅压缩至 5 秒以内,让本地 AI 应用真正实现“开箱即用”。同时,oMLX 提供与 OpenAI 及 Anthropic 兼容的 API 接口,方便开发者无缝迁移现有项目。
主要功能
原生 macOS 推理引擎:深度优化 Apple Silicon 统一内存架构,支持 M1/M2/M3 系列芯片,无需额外 GPU 或加速卡。
Paged SSD KV 缓存:突破内存限制,将长上下文推理中的键值缓存分页存储至 SSD,显著降低首 token 延迟,适合多轮对话与复杂代理场景。
兼容 OpenAI / Anthropic API:提供标准 RESTful 接口,支持 Chat Completions、Embeddings 等主流端点,一行代码即可切换本地模型。
热加载与模型管理:支持动态加载/卸载模型,无需重启服务,便于测试不同量化版本或微调模型。
轻量级部署:单二进制文件,无复杂依赖,通过 Homebrew 或手动下载即可在几分钟内完成安装。
定价与费用
- 定价:我们所审核的页面上未公开列出;请查看官方网站获取当前方案。
- 开源许可:oMLX 采用 Apache 2.0 许可证发布,可从官方网站和 GitHub 下载。
- 平台可用性:原生运行于 macOS(15+)Apple Silicon 平台,以经过签名和公证的菜单栏应用形式提供,并支持应用内自动更新。
- API 访问:本地推理服务器提供 OpenAI 和 Anthropic 兼容接口,可直接接入 Claude Code、Cursor 及其他 OpenAI 兼容客户端,无需修改代码。
适用人群
- AI 应用开发者:需要快速构建本地 LLM 驱动的工具(如智能客服、文档分析、代码生成),并希望控制推理成本与延迟。
- 隐私敏感用户:企业或个人在处理医疗、法律、金融等数据时,要求所有推理运算在本地完成,避免云端传输风险。
- macOS 性能爱好者:希望充分利用 Apple Silicon 硬件潜力,在本地运行主流开源模型(如 LLaMA、Mistral、Phi)的 Mac 用户。
- 研究与原型设计:需要快速验证多轮对话或代理工作流,且不想受限于云端 API 速率限制或网络不稳定性的研究人员。
相关教程
查看全部 →


相关工具
查看全部 → vLLM - Efficient LLM Serving vLLM 是一个专为大型语言模型设计的高吞吐量和内存高效推理与服务引擎。
 9Router - Free AI Router | Smart Fallback for Claude, Codex 智能路由 Free AI routing with smart 3-tier fallback. Maximize subscriptions, auto-switch to cheap/free models. Never stop coding with Claude Code, Codex, Gemini CLI.
 OpenRouter OpenRouter 是一个统一的、兼容 OpenAI 的 API,让开发者按用量付费调用来自 80+ 供应商的 500+ 个文本、图像、视频和音频 AI 模型。
 OmniRoute — Free AI Gateway for Multi-Provider LLMs Free, open-source AI router with auto-fallback. 236 providers, one endpoint, 95 MCP tools, 17 routing strategies, A2A protocol, auto-combo engine, semantic cache, memory & skills. Deploy anywhere.
 LangChain LangChain provides a comprehensive suite of products to support developers throughout their entire development workflow.