
Mosi Intelligence - Next-generation interactive AI. Building context-aware foundation models for universal human-computer interaction.
最后更新 2026 年 9 月 4 日
简介
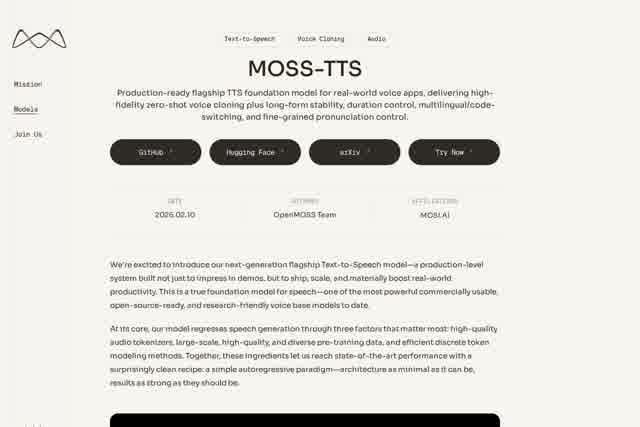
MOSI - MOSS-TTS 是由 Mosi Intelligence 倾力打造的下一代交互式 AI 语音合成系统。作为新一代上下文感知基础模型的核心组件,MOSI 致力于重新定义人机交互的边界。通过深度融合深度学习与自然语言处理技术,MOSI 不仅能够生成高度自然、富有情感的语音,更能理解对话的上下文语境,实现真正意义上的智能语音交互。无论是智能助手、虚拟角色还是自动化播报,MOSI 都能为您提供前所未有的沉浸式听觉体验。
主要功能
**多风格语音合成:**支持从新闻播报到日常对话、从情感朗读到角色扮演等多种语音风格,满足不同场景需求。
**上下文感知交互:**基于 MOSS 架构的上下文建模能力,让语音输出能够根据对话历史与当前意图进行动态调整,告别机械感。
**实时流式输出:**低延迟的流式 TTS 技术,支持边生成边播放,适用于实时对话与直播场景。
**多语言与口音适配:**原生支持中文及主要外语,并可针对特定口音或方言进行微调,实现本地化表达。
**情感与语调控制:**通过参数调节或自然语言指令,精准控制语音中的喜悦、悲伤、疑问等情感色彩。
定价与费用
- **自然度行业领先:**采用自研的声学编码器与神经声码器,合成语音的韵律、停顿与呼吸感媲美真人录音。
- **零样本克隆与定制:**仅需少量音频样本,即可快速克隆特定人声,或创建全新的虚拟音色,大幅降低定制成本。
- **深度上下文融合:**不同于传统 TTS 仅处理文本,MOSI 结合对话状态、用户画像与环境信息,输出更具逻辑与情感连贯性的语音。
- **灵活部署方案:**提供云端 API、私有化部署及边缘端 SDK,适配从大型服务器到移动设备的全场景需求。
- **持续学习进化:**基于用户反馈与使用数据,模型可在安全合规的前提下持续优化,越用越智能。
适用人群
- **AI 应用开发者:**需要为聊天机器人、虚拟主播或智能硬件集成高质量语音能力的团队。
- **内容创作者与播客主:**希望快速生成高质量旁白、有声书或视频配音的个人与工作室。
- **企业客户服务部门:**构建智能语音客服、自动外呼系统,提升客户交互体验与效率。
- **教育与无障碍领域:**为学习软件、电子读物或视障辅助工具提供自然流畅的语音支持。
- **游戏与元宇宙开发者:**为 NPC、虚拟角色赋予真实且富有情感的语音表现力。
相关教程
查看全部 →
相关工具
查看全部 → Xiaomi MiMo, Explore and Love - 探索与爱 xiaomi mimo - 探索与热爱
 Qwen AI - 阿里巴巴千问海外版 通义千问是由阿里云开发的大型语言模型,提供智能对话与文本生成服务。
 LMArena LMArena 是一个由加州大学伯克利分校 LMSYS Lab 发起的开放型、社区驱动的 AI 模型评测平台。
 LongCat AI | 美团大模型 LongCat AI 是一个专注于人工智能对话技术的平台,提供高效、智能的聊天解决方案。
 Moonshot AI 月之暗面旗下 AI 助手 Kimi,以超长上下文见长,从 20 万汉字扩展至 200 万字,支持深度搜索与编程。