简介
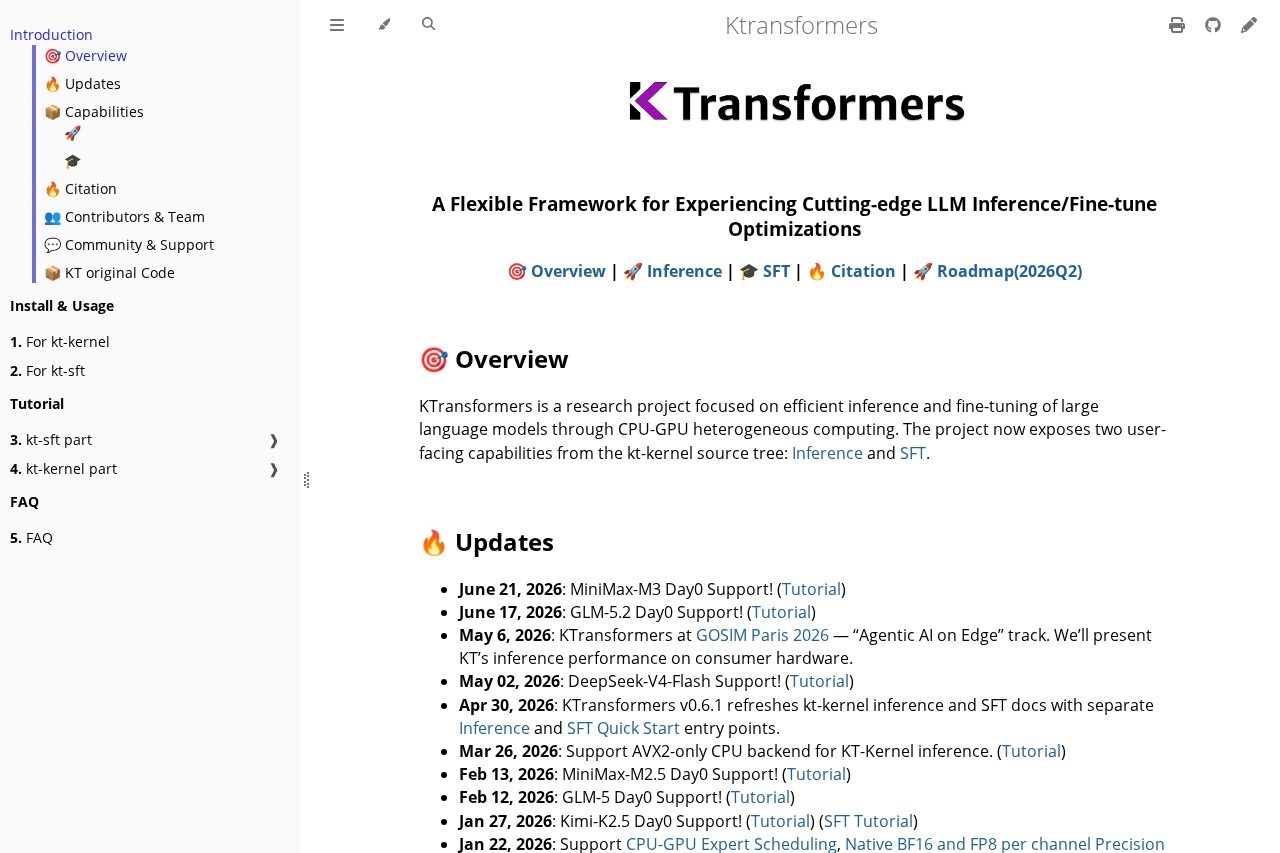
Ktransformers 是一款面向现代人工智能与高性能计算场景的轻量级框架,专注于简化大规模 Transformer 模型的部署与推理流程。通过高度优化的底层算子与灵活的接口设计,Ktransformers 帮助开发者在保持模型精度的前提下,显著提升推理速度并降低资源消耗。无论是用于研究实验还是生产环境,Ktransformers 都能为您提供稳定、高效、易用的模型运行体验。
主要功能
高效推理引擎:集成多种量化与稀疏化技术,支持 FP16、INT8、INT4 等精度,在减少显存占用的同时保持模型输出质量。
多模型兼容:原生支持主流开源 Transformer 模型(如 LLaMA、Mistral、Falcon 等),并提供统一的加载与调用接口。
动态批处理:自动合并并发请求,最大化 GPU 利用率,降低延迟,适合高并发在线服务场景。
扩展插件系统:允许用户自定义算子、注意力机制及后处理逻辑,满足个性化研究与业务需求。
一键部署工具:提供命令行与 Python API 两种模式,支持 Docker 容器化部署,快速集成至现有系统。
定价与费用
- 定价:我们所审阅的页面未公开列出定价;请访问官方网站查询当前方案。
- 开源项目:KTransformers 是一个基于 CPU-GPU 异构计算、面向高效 LLM 推理与微调的研究项目,以开源形式提供。
- 平台可用性:支持 CUDA 和 ROCm 硬件,并提供仅 AVX2 的 CPU 后端;近期工作还将支持扩展至昇腾 NPU。
- 功能范围:提供推理和 SFT 两项面向用户的能力,支持 DeepSeek、GLM、Kimi、MiniMax 等 MoE 模型的 LoRA 及全参数微调。
- 持续更新:定期发布更新,包括新模型支持(如消费级 GPU 上支持 1M token 上下文的 GLM-5.3-flash)及文档刷新。
适用人群
- AI 算法工程师:需要快速验证新模型或优化现有推理管线的研究人员。
- 后端开发工程师:希望将大模型集成到 Web 服务、API 或移动端应用中的开发者。
- 企业 IT 架构师:追求低成本、高吞吐的模型部署方案,用于客服、内容生成等业务场景。
- 独立开发者与学生:学习 Transformer 原理并尝试搭建个人 AI 应用的技术爱好者。


