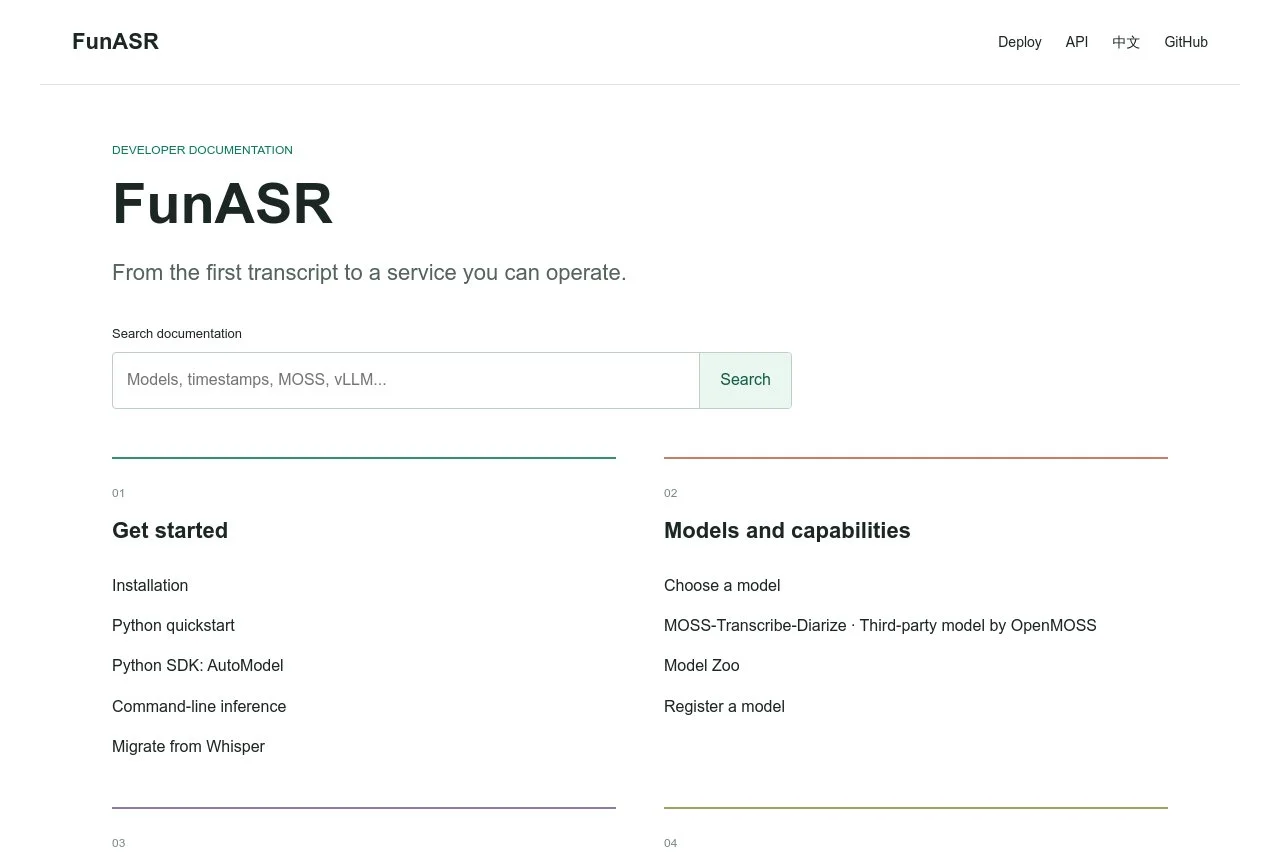
FunASR 是一款工业级端到端语音识别工具包,支持 50+ 语言,GPU 上可达 170 倍实时率,并提供说话人分离、情感检测与 OpenAI 兼容 API 等能力。
标签
最后更新 2026 年 11 月 10 日
简介
FunASR 是一款面向工业级应用的开源端到端语音识别工具包,由阿里巴巴达摩院语音实验室研发并持续维护。它集成了从语音识别、说话人分离到情感检测的完整语音处理能力,在 GPU 上可实现高达 170 倍实时率的推理速度,并支持 50 多种语言的识别。FunASR 不仅提供与 OpenAI 兼容的 API 接口,还通过 vLLM 加速技术大幅提升大模型推理效率,能够无缝接入智能体(Agent)系统,是构建高精度、低延迟语音交互应用的理想选择。
主要功能
**高精度语音识别:**基于先进的自监督学习与端到端模型,在多种噪声场景下保持稳定的识别准确率。
**多语言支持:**覆盖 50 余种语言,包括中、英、日、韩、法、德等主流语种及部分方言。
**说话人分离(Speaker Diarization):**自动区分不同说话人,输出带标签的对话文本。
**情感检测:**实时分析语音中的情绪倾向,支持愤怒、高兴、悲伤等常见情感分类。
**流式与离线双模式:**支持实时流式识别与完整音频的离线批量处理,灵活适配不同业务场景。
**Agent 集成:**提供标准化接口,可快速将语音能力嵌入智能客服、语音助手等智能体系统。
定价与费用
- 定价:我们审阅的页面上未公开列出;请访问官网查询当前方案。
- 开源工具包:FunASR 托管于 GitHub,可本地安装和运行,核心推理不产生按次调用的服务费。
- 灵活部署:支持原生 vLLM、FunASR 分离式引擎 vLLM,以及 llama.cpp 与 GGUF 模型,用户可按预算和硬件选择部署方式。
- 兼容 Whisper 的 API:提供 OpenAI 兼容接口,现有的 OpenAI/Whisper 集成可无需改写代码即可切换。
适用人群
FunASR 适合以下用户群体:
- **AI 应用开发者:**希望快速为产品添加语音识别、说话人分离或情感分析能力,减少自研成本。
- **企业技术团队:**需要部署高并发、低延迟的语音服务,用于呼叫中心、会议记录、直播字幕等场景。
- **智能体与 RPA 开发者:**希望将语音交互集成到 Agent 工作流中,实现语音驱动的自动化任务。
- **学术研究者:**需要灵活、可复现的基线系统进行语音技术实验与对比。
相关教程
查看全部 →


相关工具
查看全部 → 听脑AI - 录音助手 听脑AI是一款专业智能录音转文字工具,采用AI技术实现98%准确率的实时语音转写,支持多场景会议记录与智能总结,3分钟即可处理1小时会议内容。
 IBM Watson text-to-speech 提供多语言语音转文本API,支持SaaS及本地化部署。
 讯飞文书 讯飞文书提供智能化文档创作与办公效率提升解决方案。
 MP3ToText 【产品简介】 MP3 to Text(mp3totext.io)是一款面向全球用户的在线 AI 语音转文字工具,帮助用户将 MP3、WAV、M4A、MP4 等音频/视频内容快速转换为可编辑、可搜索的文本。无需安装软件,打开浏览器即可使用。 【核心功能】 · 免费在线转录:访客可直接试用;注册后可保存历史记录,并获得更高每日额度 · 文件上传:上传本地 MP3、WAV、M4A、MP4 等音视频文件,即可开始转录 · 多格式支持:兼容 MP3、WAV、M4A、FLAC、MP4、MOV、WebM 等常见音视频格式 · 150+ 语言识别:支持自动检测或手动选择音频语言 · 时间戳与说话人识别:生成带时间轴的结构化文稿,便于定位与引用 · AI 智能增强:可生成内容摘要、思维导图,帮助快速理解长录音 · 在线编辑:支持段落编辑、全文搜索与替换,便于校对和修改 · 多格式导出:支持 TXT、PDF、DOCX、CSV、SRT、VTT 等格式,满足字幕、文档、研究笔记等需求 · 字幕生成:可生成 SRT/VTT 字幕文件,适用于视频创作与后期制作
 Inworld AI Inworld AI 为开发消费级应用的团队提供实时语音模型(文字转语音、语音转文字、语音到语音)以及托管的开放 LLM 推理服务,适合 AI 陪伴、教育、客服语音代理与游戏等场景。