DeepEval is the open-source LLM evaluation framework for testing and benchmarking LLM applications — 50+ plug-and-play metrics for AI agents, RAG, chatbots, and more.
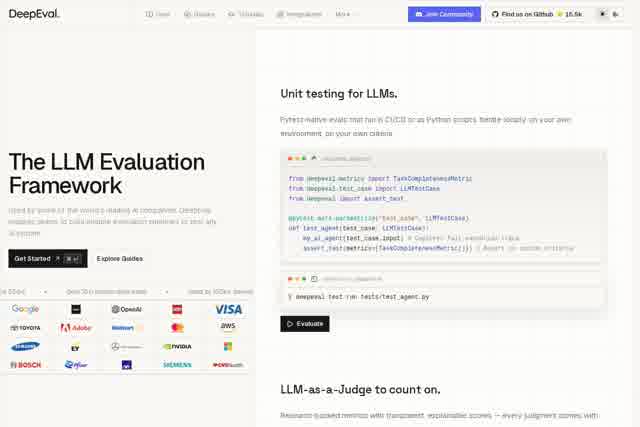
简介
在现代人工智能应用开发中,大语言模型的评估与测试已成为决定项目成败的关键环节。DeepEval by Confident AI 是一款开源的 LLM 评估框架,专为测试和基准测试 LLM 应用而设计。无论您正在构建 AI 智能体、RAG 系统、聊天机器人还是其他基于语言模型的应用,DeepEval 都能提供超过 50 种即插即用的评估指标,帮助开发团队快速、可靠地衡量模型输出的质量、准确性与安全性。作为一款轻量级但功能强大的工具,DeepEval 致力于让 LLM 评估像单元测试一样简单、可重复且可集成。
主要功能
定价与费用
- 定价:我们所审查的页面未公开列出定价;请查看官方网站了解当前方案。
- 开源框架:DeepEval 是一个代码公开的开源项目,核心框架可免费使用。
- 自托管评估:支持本地运行并提供本地后端存储选项,团队可自行控制评估数据与结果的存放位置。
- CI/CD 集成:评估脚本采用 pytest 单元测试风格,可在 CI/CD 流水线中运行,用于持续回归测试。
适用人群
DeepEval 适合所有参与 LLM 应用开发与运维的专业人士,包括但不限于:
**AI 应用开发者:**需要在开发过程中持续验证模型输出质量,确保功能正确性。
**机器学习工程师与数据科学家:**希望系统化地比较不同模型、提示词或检索策略的性能差异。
**QA 与测试工程师:**寻求自动化评估方案,将 LLM 行为测试纳入标准测试流程。
**产品经理与技术负责人:**需要客观指标来驱动产品迭代决策,并监控上线后的模型表现。
常见问题
DeepEval 是否支持非英语语言?是的,DeepEval 的评估指标大多基于模型内部语义理解或可配置的参考标准,因此可以应用于中文、英文等多语言场景。
需要付费才能使用全部指标吗?所有 50+ 评估指标在开源版本中均可免费使用。Confident AI 云端平台提供高级协作与可视化功能,但核心框架完全免费。
如何将 DeepEval 集成到现有项目?只需通过 pip 安装,然后使用 Python 导入并编写评估用例。官方文档提供了与 LangChain、LlamaIndex 等框架的详细集成示例。
DeepEval 与 LangSmith、Weights & Biases 有何不同?DeepEval 更专注于提供细粒度、可编程的评估指标与测试框架,尤其适合自动化测试场景;而其他平台更偏向实验跟踪与全栈监控。三者可以互补使用。
相关教程
查看全部 →


相关工具
查看全部 → 智谱清言 (ChatGLM) 智谱清言是基于智谱 AI GLM 大模型的中文对话式助手,集对话、智能体与图像、视频、PPT 等多模态创作工具于一体,主要面向中文用户。
 Poe Poe 是 Quora 推出的多模型 AI 聊天平台,用户可以在同一个界面与多个 AI 助手对话、对比回答,还能创建并分享自定义机器人。
 Claude Claude 是 Anthropic 推出的 AI 助手,通过自然对话回答问题、撰写和编辑文本、分析文档并协助编程,适合写作者、研究人员和开发者使用。
 Openclaw(clawdbot) - Presonal AI Assistant Moltbot是一款跨平台个人AI助手,能够执行实际任务。
 Gemini Google 推出的 AI 助手,帮助用户完成写作、规划、头脑风暴、学习与编程等日常任务,通过 Google 账号即可在网页端和移动端使用。