Introdução
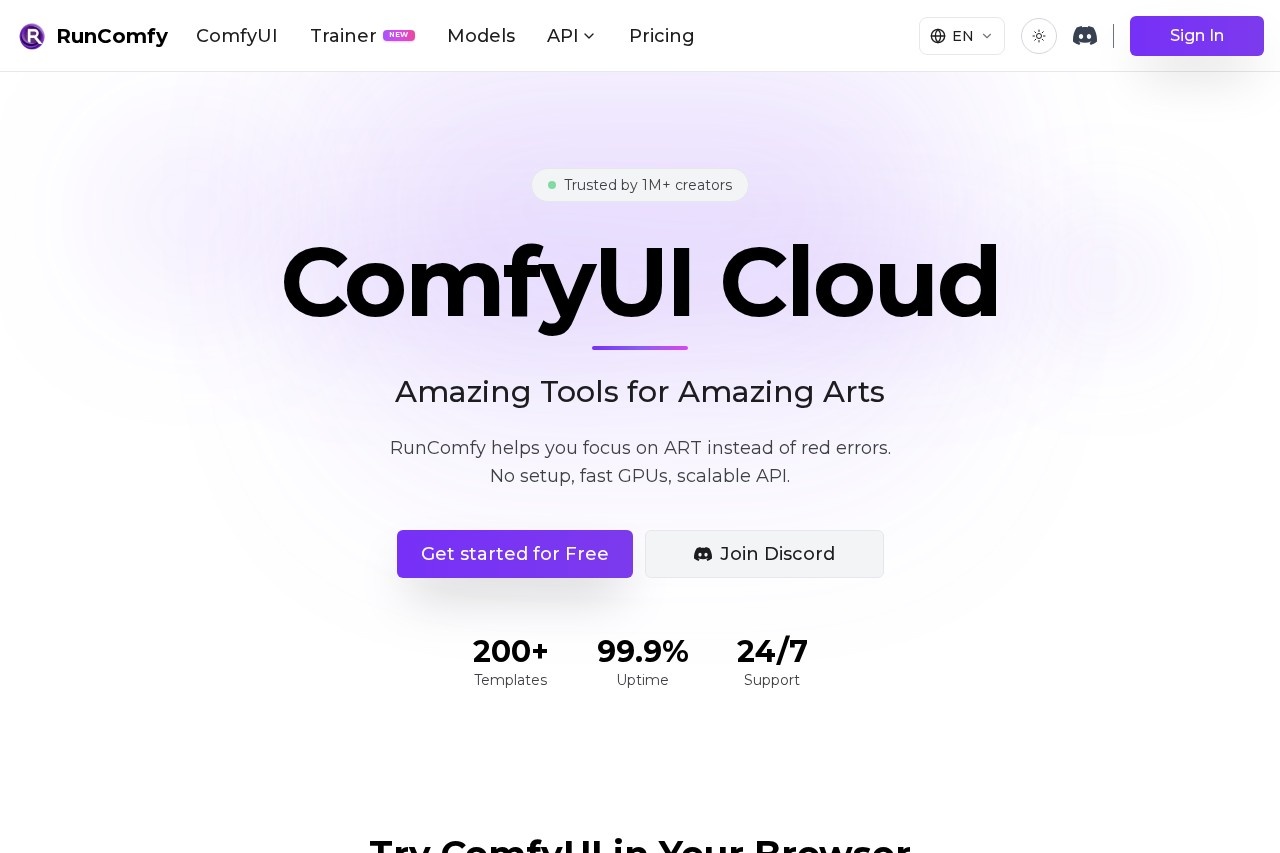
RunComfy é um serviço na nuvem para executar o ComfyUI, a interface gráfica baseada em nós para Stable Diffusion e outros modelos de IA generativa, sem instalar nada localmente. Configurar o ComfyUI em uma máquina pessoal normalmente envolve resolver dependências, instalar nós personalizados, baixar arquivos de modelos gigantes e ter uma GPU potente — tarefas que podem levar horas antes da primeira imagem ser gerada. O RunComfy elimina essa barreira ao fornecer um ambiente ComfyUI pré-configurado que roda no navegador em aluguel de hardware de GPU.
Os usuários começam com uma conta gratuita, iniciam uma sessão nativa do ComfyUI na nuvem e podem construir workflows do zero, escolher entre mais de 200 templates prontos para uso ou enviar um arquivo workflow.json existente, que um agente de configuração automática ajusta sozinho. Além do uso interativo, o RunComfy permite que qualquer workflow salvo seja implantado como um endpoint de API serverless com auto-scaling conforme a demanda. A plataforma se descreve como confiável por mais de um milhão de criadores e oferece máquinas de GPU com VRAM de 16GB a 141GB.
Principais Recursos
- ComfyUI na nuvem sem configuração: Os usuários obtêm um ambiente ComfyUI não modificado e totalmente configurado no navegador, então os workflows se comportam como rodariam localmente e podem começar a executar em segundos.
- Agente de configuração automática para arquivos de workflow: Ao enviar um arquivo workflow.json, o RunComfy resolve dependências, nós personalizados e downloads de modelos automaticamente; o usuário então abre um link e executa o workflow.
- Mais de 200 templates prontos para uso: Uma biblioteca curada cobre workflows de texto-para-imagem, edição de imagens e geração guiada por layout, construídos em torno de modelos como Flux 3 Klein, Qwen Image 2.1 Turbo, MOSS-Image e Fibo 2 Edit Turbo.
- Implantação de API serverless: Qualquer workflow salvo na nuvem pode se tornar um endpoint de produção com um clique; o RunComfy cuida da replicação do ambiente, orquestração de GPU e auto-scaling, e o endpoint escala a zero quando ocioso.
- Downloads gratuitos de modelos do Civitai e Hugging Face: Os usuários podem baixar modelos diretamente do Civitai, Hugging Face e Google Drive — o que, segundo a empresa, é 25 vezes mais rápido do que uploads locais — e os modelos persistem entre as sessões.
- Instalação de nós personalizados: O ComfyUI-Manager está incluído, permitindo que os usuários instalem quaisquer nós da comunidade que precisarem.
- Ambientes de workflow reproduzíveis: Cada workflow salvo armazena o JSON, sistema operacional, ambiente Python, versão do ComfyUI, nós personalizados e modelos como um snapshot que pode ser reaberto ou compartilhado com colegas por meio de um link.
Destaques
- Preços: As taxas de GPU pagas por uso começam em $0,99/hora para máquinas com 16GB de VRAM (T4/A4000) e chegam a $9,59/hora para uma H200 com 141GB de VRAM, cobradas por segundo. Uma assinatura Pro custa $19,99/mês cobrados anualmente ($29,99 mensais) e inclui mais de 20% de desconto nas taxas de GPU, 20 horas grátis de CPU por mês, um crédito mensal de $10, workflows salvos ilimitados e 200GB de armazenamento.
- Plano gratuito: Os usuários podem começar gratuitamente, sem necessidade de assinatura.
- Preços de treinamento: Treinamentos na H100 custam $4,49/hora e na H200 $6,89/hora (pagamento por uso), com as GPUs liberadas automaticamente quando os trabalhos terminam para evitar cobranças ociosas.
- Limites de armazenamento: Contas pagas por uso incluem 10GB de armazenamento, com assets inativos removidos após 90 dias; contas Pro recebem 200GB com retenção permanente e até 10 ambientes de workflow salvos no plano gratuito.
Para Quem É
O RunComfy é voltado para artistas digitais e criadores que querem usar o ComfyUI sem possuir uma GPU de alto desempenho ou lidar com instalações complicadas. Também atende profissionais de VFX — a plataforma hospeda um curso de oito horas ministrado por um compositor sênior — e desenvolvedores de IA que precisam levar um pipeline do ComfyUI do protótipo a uma API de produção que escala com o tráfego. Praticantes de machine learning que treinam modelos grandes se beneficiam do serviço dedicado Trainer em GPUs de 80GB e 141GB, enquanto equipes podem compartilhar ambientes de workflow totalmente configurados por meio de links simples, em vez de reproduzir configurações manualmente.