Introdução
Reworkd era uma plataforma de extração de dados da web que usava agentes de IA para automatizar todo o pipeline de scraping, desde a varredura de sites e a geração de código de extração até a execução de scrapers, a validação de resultados e a entrega de dados estruturados. A empresa, Reworkd AI, Inc., tinha sede em São Francisco e contava com o apoio de investidores como Paul Graham, Nat Friedman e Daniel Gross. Seu objetivo era eliminar a carga de engenharia necessária para construir e manter crawlers em um grande número de sites.
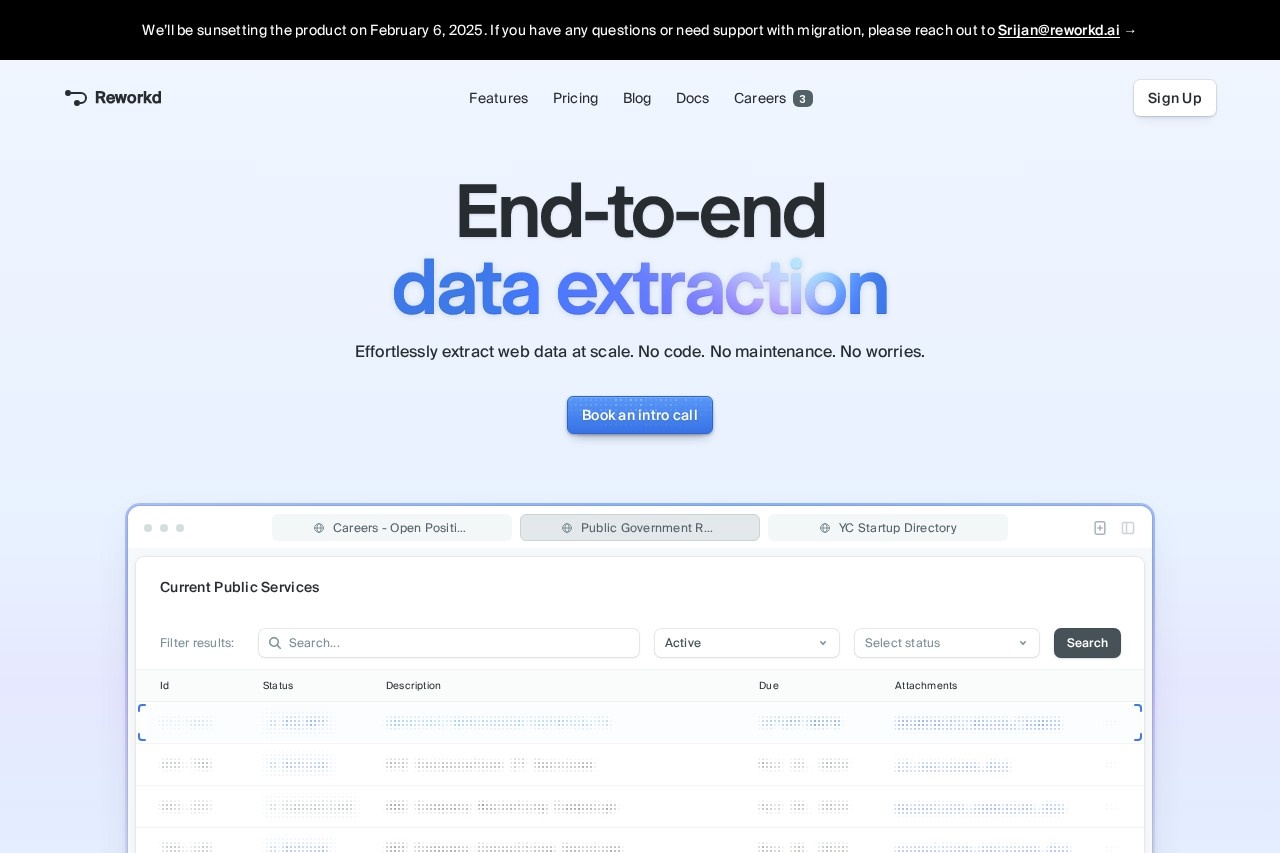
O Reworkd lidava com dificuldades comuns de scraping, como paginação, scroll infinito, conteúdo dinâmico, limitação de taxa e gerenciamento de proxies, sem exigir que os usuários escrevessem ou mantivessem código. De acordo com um aviso no site oficial, o produto foi descontinuado em 6 de fevereiro de 2025, e usuários com dúvidas sobre migração foram orientados a entrar em contato com a equipe por e-mail.
Principais Recursos
- Extração automatizada: agentes de IA analisavam páginas da web e geravam o código necessário para extrair os dados específicos solicitados pelo usuário, sem scripts manuais.
- Scrapers autorreparáveis: quando os sites alteravam sua estrutura, o Reworkd detectava o problema e corrigia automaticamente as falhas de extração.
- Pipeline de ponta a ponta: um único sistema cobria varredura, geração de código, execução da extração, validação e entrega dos dados.
- Gestão de infraestrutura: a plataforma gerenciava proxies, navegadores headless, tentativas de repetição e outras sobrecargas operacionais em nome do usuário.
- Trabalhos agendados: as tarefas de scraping podiam ser executadas em um cronograma, permitindo o monitoramento contínuo de dados da web.
- Resolução de captchas e antibot: serviços integrados tratavam de captchas e proteções antibot, cobrados por mil resoluções.
- Acesso via API: os dados extraídos estavam disponíveis por meio de uma API em todos os planos.
Destaques
- Preços: um plano Hobby gratuito (10 navegadores simultâneos, retenção de dados de 30 dias), um plano Pro por US$ 99/mês (50 navegadores simultâneos, retenção de 90 dias) e um plano Enterprise personalizado.
- Custos de uso: proxies padrão a US$ 0,125/GB, proxies premium a US$ 8/GB, computação a US$ 0,10/hora e resolução antibot a US$ 5 por 1.000 resoluções.
- Status do produto: o Reworkd foi descontinuado em 6 de fevereiro de 2025, conforme o aviso em seu site oficial; deve ser considerado desativado.
- Plano gratuito: o plano Hobby era gratuito e incluía acesso à API, resolução de captchas, trabalhos agendados e um serviço totalmente gerenciado.
Para Quem Era
O Reworkd era voltado para equipes que precisavam de dados estruturados de muitos sites, mas não tinham capacidade de engenharia para construir e manter scrapers. Os usuários típicos incluíam engenheiros de dados cansados de manter scripts de extração frágeis, pesquisadores de mercado e competitividade que monitoravam anúncios em sites concorrentes, e analistas que coletavam dados governamentais ou de diretórios em larga escala. Era posicionado como uma alternativa à contratação de especialistas em scraping ou à dedicação de desenvolvedores internos à infraestrutura de dados.