Introdução
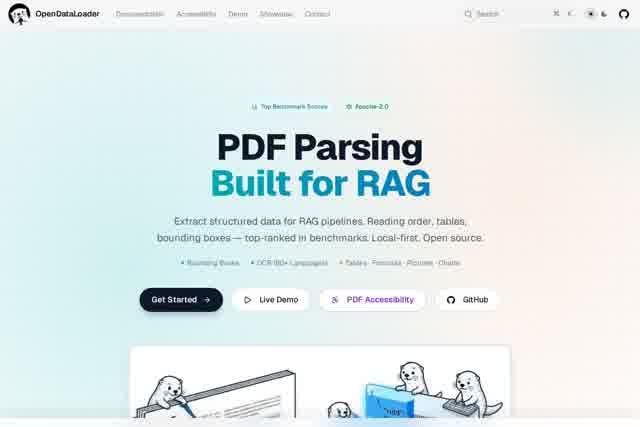
À medida que a inteligência artificial e os modelos de linguagem de grande escala (LLMs) continuam evoluindo rapidamente, o parsing estruturado de documentos PDF tornou-se uma etapa crítica na preparação de dados. O OpenDataLoader PDF é um parser de PDF local e open-source construído especificamente para prontidão de dados de IA, convertendo arquivos PDF de forma eficiente em formatos Markdown e JSON prontos para LLMs. A ferramenta suporta referências de bounding box e converte automaticamente PDFs não marcados em PDFs marcados, garantindo conformidade com padrões de acessibilidade. Licenciado sob Apache-2.0, o OpenDataLoader PDF roda inteiramente na sua máquina local, sem dependência de serviços em nuvem, protegendo a segurança e a privacidade dos dados.
Principais Recursos
- Conversão para Formatos Prontos para LLM: Converte com precisão o conteúdo de PDFs nos formatos Markdown e JSON, preservando a estrutura e a hierarquia do documento, facilitando que grandes modelos de linguagem leiam e treinem diretamente com os dados.
- Referências de Bounding Box: Registra as coordenadas de bounding box de cada elemento durante a extração de texto, permitindo análise precisa de layout e posicionamento de conteúdo para melhorar a acurácia da extração de dados.
- Marcação Automática: Detecta e adiciona automaticamente tags semânticas a PDFs não marcados, gerando PDFs marcados que atendem aos padrões de acessibilidade e apoiam a disseminação inclusiva da informação.
- Processamento 100% Local: Todo o parsing e a conversão acontecem inteiramente no dispositivo local do usuário, sem upload de arquivos para a nuvem, eliminando qualquer risco de vazamento de dados.
Destaques
- Preço: O OpenDataLoader PDF é gratuito e open-source sob a licença Apache-2.0, sem planos pagos listados no site oficial.
- Gratuito e self-hosted: Roda 100% localmente sem necessidade de GPU, processando cerca de 20+ páginas por segundo em CPU, sem custos por página ou de uso de API.
- SDKs disponíveis: SDKs oficiais para Python, Node.js e Java podem ser instalados a partir de gerenciadores de pacotes padrão como pip e npm.
- Modo híbrido opcional: Um modo opcional aprimorado por LLM melhora o OCR e a extração de tabelas complexas (93% de acurácia em tabelas em benchmarks), o que pode gerar custos de APIs de LLMs de terceiros.
Para Quem É
O OpenDataLoader PDF foi projetado para engenheiros de IA e cientistas de dados que precisam converter rapidamente grandes volumes de documentos PDF em dados de treinamento para construir sistemas RAG ou fazer fine-tuning de LLMs. Também é ideal para desenvolvedores de processamento de documentos que desejam integrar parsing de PDF em aplicações locais com requisitos rigorosos de privacidade de dados, especialistas em conformidade de acessibilidade responsáveis por converter PDFs não marcados em formatos acessíveis, e pesquisadores acadêmicos que precisam extrair dados estruturados de artigos e relatórios para análise bibliométrica ou descoberta de conhecimento.