Introdução
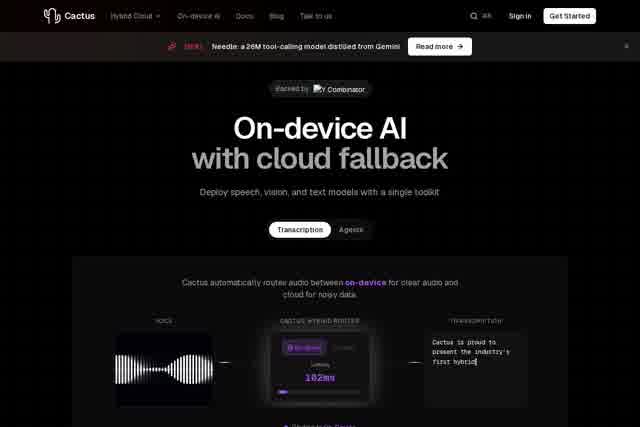
O Cactus é um motor de IA local desenvolvido para smartphones, laptops e hardware de borda. Ele oferece um runtime de inferência unificado que permite aos desenvolvedores executar grandes modelos de linguagem (LLMs), transcrição de fala e embeddings de texto diretamente nos dispositivos dos usuários finais. A principal força do Cactus está em mover o processamento de IA da nuvem para o dispositivo local, garantindo a privacidade dos dados enquanto entrega tempos de resposta em nível de milissegundos. Quando o poder de processamento do dispositivo é insuficiente, ele faz fallback automaticamente para a nuvem, garantindo um serviço ininterrupto.
Principais Recursos
- Suporte a múltiplos modelos: Executa perfeitamente LLMs de código aberto populares (como Llama e Mistral), modelos de transcrição de fala Whisper e uma variedade de modelos de embeddings.
- Fallback automático para a nuvem: Quando o poder de processamento do dispositivo local é insuficiente ou um modelo específico não está instalado, as solicitações de inferência são automaticamente encaminhadas para a nuvem, sem nenhuma mudança perceptível para o usuário.
- API unificada multiplataforma: Uma única interface de inferência cobre dispositivos Android, iOS, Windows, macOS e Linux de borda, reduzindo significativamente os custos de integração.
- Implantação leve: O motor principal tem apenas alguns MB de tamanho e suporta carregamento e cache dinâmico de modelos, sem consumir armazenamento em excesso.
- Offline-first: Todas as tarefas de inferência rodam localmente por padrão, e as funcionalidades básicas de IA funcionam sem nenhuma conexão de rede.
Destaques
- Preços: Não listado publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Planos de fine-tuning hospedado: O site expõe um endpoint de planos para fine-tuning hospedado e referencia os níveis Starter (compra única) e Pro (assinatura), com chaves de API gerenciadas no painel de cobrança.
- Uso local gratuito: O modelo base Needle 3 está disponível para download aberto e pode ser executado e avaliado localmente sem custo; o reconhecimento de fala Whistle e o Needle 3 são modelos abertos.
- Pegada dos modelos: O Needle 3 é distribuído como um binário único de 8–29 MB com quantização sub-2-bit; os menores modelos rodam apenas com CPU em celulares econômicos, wearables e Raspberry Pis, sem necessidade de GPU ou servidor.
Para Quem É
O Cactus é projetado para desenvolvedores de aplicativos móveis que buscam integrar recursos de chat inteligente, tradução em tempo real ou assistente de voz em seus aplicativos; engenheiros de computação de borda que precisam executar inferência de IA em dispositivos de baixo consumo, como gateways IoT e PCs industriais; equipes de TI corporativas que buscam processamento de dados on-premise mantendo a capacidade de escalar elasticamente através da nuvem; desenvolvedores independentes e startups que desejam validar rapidamente protótipos de produtos de IA sem incorrer em altos custos iniciais de serviços em nuvem; e pesquisadores acadêmicos que precisam testar e fazer fine-tuning de modelos em hardware local sem depender de clusters de servidores de laboratório.