Introdução
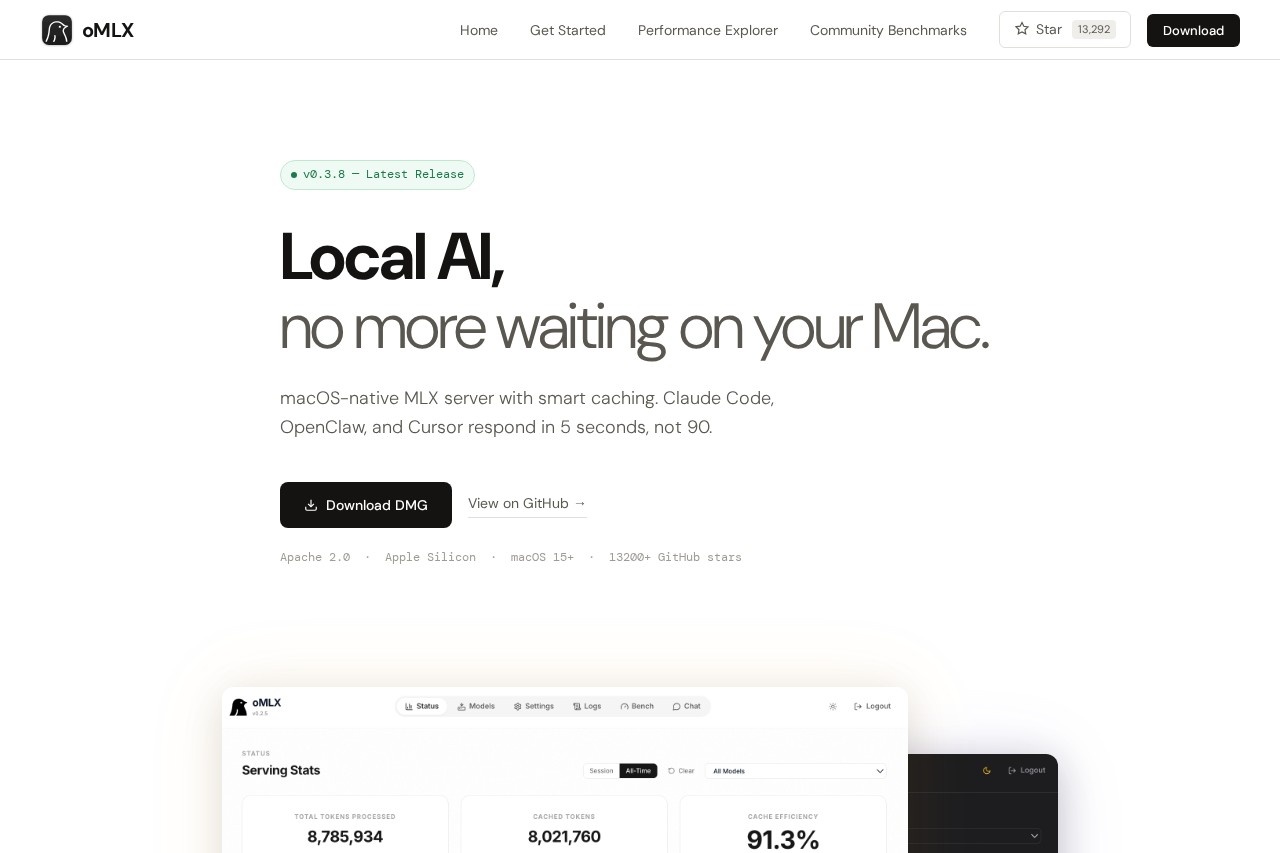
O oMLX é um servidor de inferência nativo projetado especificamente para o macOS, construído sobre o framework MLX da Apple para liberar todo o potencial de deep learning dos chips Apple Silicon. Se você está executando modelos de linguagem de grande porte (LLMs) ou construindo aplicações de agentes inteligentes, o oMLX oferece inferência local eficiente e de baixa latência. Com sua inovadora tecnologia de cache KV paginado em SSD, o oMLX reduz drasticamente o tempo até o primeiro token (TTFT) em tarefas de agentes, dos tradicionais 30-90 segundos para menos de 5 segundos, tornando as aplicações de IA local verdadeiramente prontas para uso imediato. Além disso, o oMLX oferece interfaces de API compatíveis com OpenAI e Anthropic, permitindo que desenvolvedores migrem projetos existentes com o mínimo de esforço.
Principais Recursos
- Motor de inferência nativo do macOS: profundamente otimizado para a arquitetura de memória unificada do Apple Silicon, com suporte aos chips das séries M1/M2/M3, sem necessidade de GPUs ou placas aceleradoras adicionais.
- Cache KV paginado em SSD: supera os limites de memória ao paginar os caches de chave-valor para o SSD durante inferências de contexto longo, reduzindo significativamente a latência do primeiro token em conversas com múltiplas interações e cenários complexos de agentes.
- API compatível com OpenAI / Anthropic: fornece endpoints RESTful padrão, incluindo Chat Completions e Embeddings, permitindo migrar para modelos locais com uma única linha de código.
- Carregamento dinâmico e gerenciamento de modelos: suporta carregamento e descarregamento dinâmico de modelos sem reiniciar o serviço, facilitando o teste de diferentes versões quantizadas ou modelos ajustados (fine-tuned).
- Implantação leve: um único arquivo binário sem dependências complexas, instalável em minutos via Homebrew ou download manual.
Destaques
- Preços: não estão publicamente listados nas páginas que analisamos; consulte o site oficial para ver os planos atuais.
- Licença open source: o oMLX é distribuído sob a licença Apache 2.0, com downloads disponíveis no site oficial e no GitHub.
- Disponibilidade de plataformas: roda nativamente no macOS (15+) em Apple Silicon; distribuído como um app de barra de menus assinado e notarizado, com atualização automática.
- Acesso via API: o servidor de inferência local expõe endpoints compatíveis com OpenAI e Anthropic, funcionando como substituto direto (drop-in) no Claude Code, Cursor e outros clientes compatíveis com OpenAI, sem alteração de código.
Para Quem É
Desenvolvedores de aplicações de IA que precisam construir rapidamente ferramentas locais baseadas em LLMs (como atendimento inteligente ao cliente, análise de documentos ou geração de código), mantendo os custos e a latência da inferência sob controle. Usuários preocupados com privacidade, em ambientes corporativos ou individuais, que lidam com dados médicos, jurídicos ou financeiros e exigem que toda a inferência seja executada localmente para evitar os riscos de transmissão em nuvem. Entusiastas de desempenho no macOS que querem aproveitar ao máximo o hardware Apple Silicon para executar localmente modelos open source populares (como LLaMA, Mistral e Phi). Pesquisadores e equipes de prototipagem que precisam validar rapidamente fluxos de conversas com múltiplas interações ou workflows de agentes, sem estarem limitados por restrições de taxa de APIs em nuvem ou instabilidade de rede.