
Introdução
Lakera Guard é uma plataforma de segurança da Lakera que protege agentes de IA corporativos ao longo de todo o seu ciclo de vida, desde a descoberta inicial até a aplicação de proteções em tempo real. Ela resolve um problema que muitas organizações enfrentam atualmente: funcionários e equipes estão implantando agentes de IA em ferramentas, APIs e fluxos de trabalho mais rápido do que as equipes de segurança conseguem inventariá-los ou governá-los, criando pontos cegos sobre o que esses agentes podem acessar e quais ações podem executar.
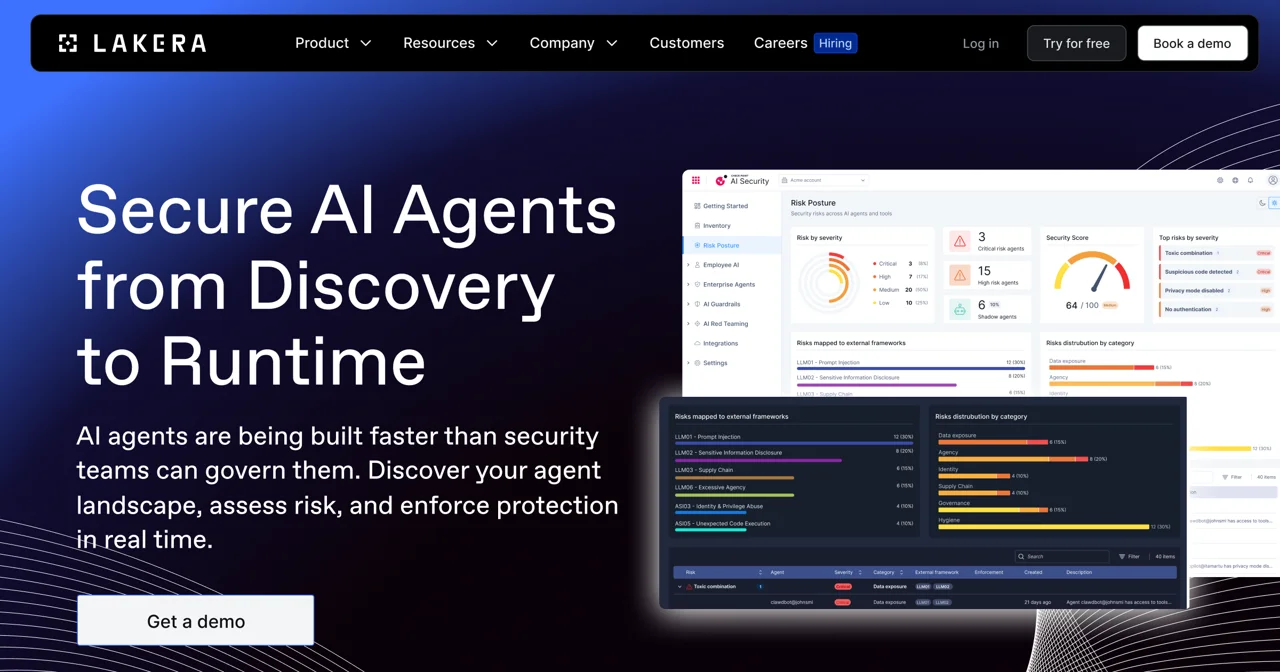
Em linhas gerais, o Lakera Guard funciona em três etapas. Primeiro, ele se conecta ao ecossistema de agentes de uma organização — incluindo ambientes em nuvem, low-code e personalizados — para revelar quais agentes e ferramentas conectadas via MCP existem, inclusive aqueles que nunca foram registrados formalmente. Em seguida, avalia o risco de cada agente com base em sua configuração, acesso a dados, servidores MCP conectados e nível de autonomia. Por fim, aplica políticas e guardrails em tempo de execução que bloqueiam injeção de prompts, jailbreaks, vazamento de dados e ações não autorizadas de agentes. A Lakera afirma que o produto é implantado em minutos, não exige alterações em modelos ou prompts existentes e não adiciona latência perceptível, com latência em tempo de execução inferior a 50 ms citada em seu site.
Recursos Principais
- Descoberta e visibilidade de agentes: Encontra automaticamente agentes de IA e ferramentas conectadas via MCP em todo o ambiente corporativo, incluindo agentes que as equipes não construíram ou registraram explicitamente, fechando a lacuna de "você não pode proteger o que não consegue ver".
- Avaliação da postura de risco: Avalia cada agente de acordo com sua configuração, ferramentas, acesso a dados e APIs, servidores MCP e grau de autonomia, para que as equipes de segurança entendam a exposição antes que problemas surjam.
- Aplicação de políticas e guardrails em tempo de execução: Bloqueia ataques de injeção de prompts, jailbreaks, instruções adversariais, vazamento de dados sensíveis em prompts e respostas, uso inseguro de ferramentas e ações não autorizadas enquanto os agentes operam.
- Defesa contra injeção indireta de prompts para sistemas conectados via MCP: Bloqueia instruções maliciosas que chegam por meio de ferramentas conectadas antes que um agente as execute — um risco fundamental à medida que agentes chamam sistemas externos.
- Cobertura de ciclo de vida completo: Cobre toda a jornada do agente — descoberta e avaliação, governança e aplicação de políticas, e proteção em tempo real — em vez de filtrar apenas as entradas em um único ponto.
- Implantação sem alterações: É implantado em minutos sem modificar modelos ou prompts, e a Lakera reporta latência em tempo de execução inferior a 50 ms, de modo que a experiência do usuário não é afetada de forma perceptível.
- Detecção de ameaças multilíngue e multimodal: A Lakera cita a observação de mais de 100 idiomas em tempo real e aprendizado de uma comunidade com mais de 1.000.000 de hackers, permitindo a detecção de várias variantes de ataques.
Destaques
- Preços: Não listados publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Como começar: O site oferece uma opção "Start for free" além do agendamento de demonstrações, permitindo que usuários em potencial comecem sem uma conversa imediata com vendas.
- Parte de um portfólio mais amplo: O Lakera Guard faz parte do conjunto de segurança de IA da Lakera, que também inclui o Workforce AI Security para o uso de IA por funcionários e serviços de AI Red Teaming conduzidos por especialistas.
- Riscos de foco: Injeção de prompts (direta e indireta), jailbreaks, vazamento de dados de IA, geração de conteúdo tóxico, riscos de conformidade e regulatórios, e ataques multilíngues ou multimodais.
Para Quem É
O Lakera Guard é voltado para engenheiros de segurança, CISOs e equipes de plataformas de IA em organizações que constroem ou operam agentes de IA, copilotos e aplicações baseadas em RAG. Ele atende equipes que executam agentes conversacionais, agentes de documentos ou RAG, agentes conectados usando servidores MCP e implantações de gateways de GenAI. É especialmente relevante quando os agentes têm acesso a dados sensíveis, APIs internas ou privilégios elevados — situações em que um agente mal direcionado ou comprometido poderia expor informações ou disparar ações não autorizadas — e onde a revisão de segurança precisa acompanhar a rápida adoção de IA.




