Introdução
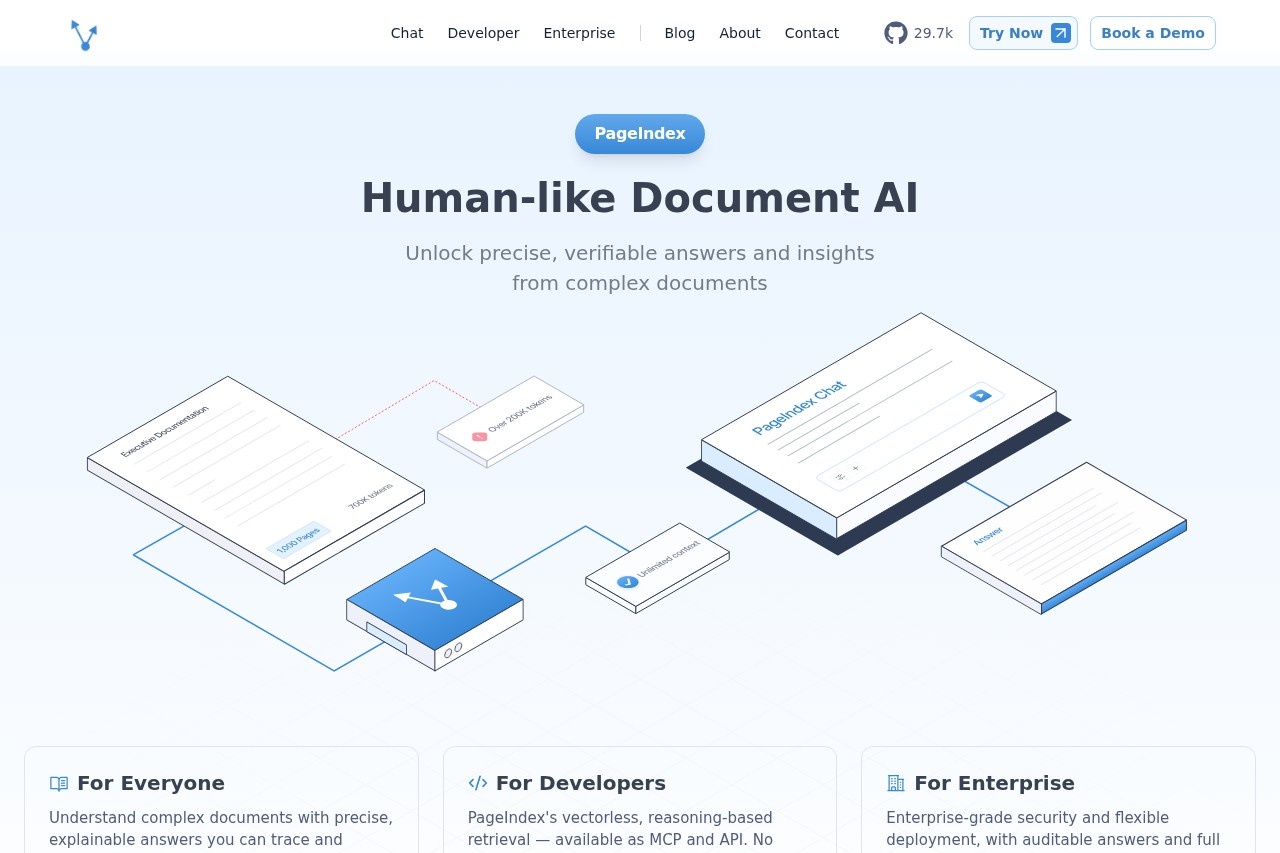
Em uma era de sobrecarga de informações, processar documentos longos — como relatórios financeiros, contratos jurídicos ou artigos acadêmicos — muitas vezes exige tempo e esforço consideráveis. As técnicas tradicionais de geração aumentada por recuperação (RAG) podem auxiliar na compreensão, mas frequentemente dependem de embeddings vetoriais que quebram as conexões contextuais, levando a respostas fragmentadas e imprecisas. O PageIndex foi criado para resolver esse problema. É um mecanismo RAG inovador, sem vetores e baseado em raciocínio, projetado para imitar a maneira como os humanos leem e entendem documentos. Ao seguir uma abordagem única de "entender primeiro, recuperar depois", o PageIndex alcança 98,7% de precisão no benchmark FinanceBench, entregando não apenas respostas precisas, mas também garantindo que cada etapa da recuperação seja claramente rastreável. Isso torna a compreensão inteligente de documentos genuinamente confiável e explicável.
Principais Recursos
- Motor de raciocínio sem vetores: em vez de embeddings vetoriais tradicionais, o PageIndex usa modelos de deep learning para analisar diretamente a estrutura e a lógica semântica do documento, permitindo associação de parágrafos e localização de informações de forma semelhante à humana.
- Caminhos de recuperação explicáveis: cada resposta vem com uma cadeia completa de rastreabilidade, mostrando claramente o processo de raciocínio da pergunta à resposta, permitindo que os usuários verifiquem facilmente a autenticidade das informações.
- Processamento de documentos longos com alta precisão: suporta documentos complexos de centenas de páginas, mantendo a consistência contextual em referências cruzadas de múltiplas tabelas e raciocínios de passagens longas, sem perder informações-chave.
- Perguntas e respostas interativas em tempo real: os usuários podem fazer perguntas de acompanhamento sobre qualquer parte do documento, e o PageIndex ajusta dinamicamente sua estratégia de recuperação para fornecer respostas contínuas e precisas.
Destaques
- Preços: não listados publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Opções de acesso: disponível como um app Chat hospedado, um painel para desenvolvedores com cadastro self-service e gerenciamento de chaves de API, e uma API REST com SDK Python e servidor MCP para integração.
- Componente open-source: o PageIndex Flash, uma ferramenta rápida de indexação em árvore, é oferecido como código aberto.
- Requisitos de implantação: o motor é sem vetores, portanto não há necessidade de banco de dados vetorial ou infraestrutura de chunking, o que pode reduzir os custos de implantação.
- Demonstração disponível: empresas podem solicitar uma demo pelo site oficial para um onboarding personalizado.
Para Quem É
Analistas financeiros e auditores podem extrair rapidamente dados-chave de prospectos e demonstrações financeiras, garantindo citações precisas e aumentando a eficiência do due diligence e da redação de relatórios. Profissionais jurídicos e de compliance podem interpretar com precisão cláusulas contratuais e documentos regulatórios com vinculação automática de referências cruzadas, reduzindo o risco de falhas na revisão manual. Pesquisadores e editores acadêmicos podem navegar com eficiência por revisões de artigos e métodos experimentais, usando a recuperação rastreável para apoiar a análise de literatura e a revisão por pares. Equipes de gestão do conhecimento corporativo podem transformar grandes repositórios de documentos internos em sistemas inteligentes de perguntas e respostas, capacitando os funcionários com busca self-service e reduzindo o trabalho repetitivo de suporte.