
Introdução
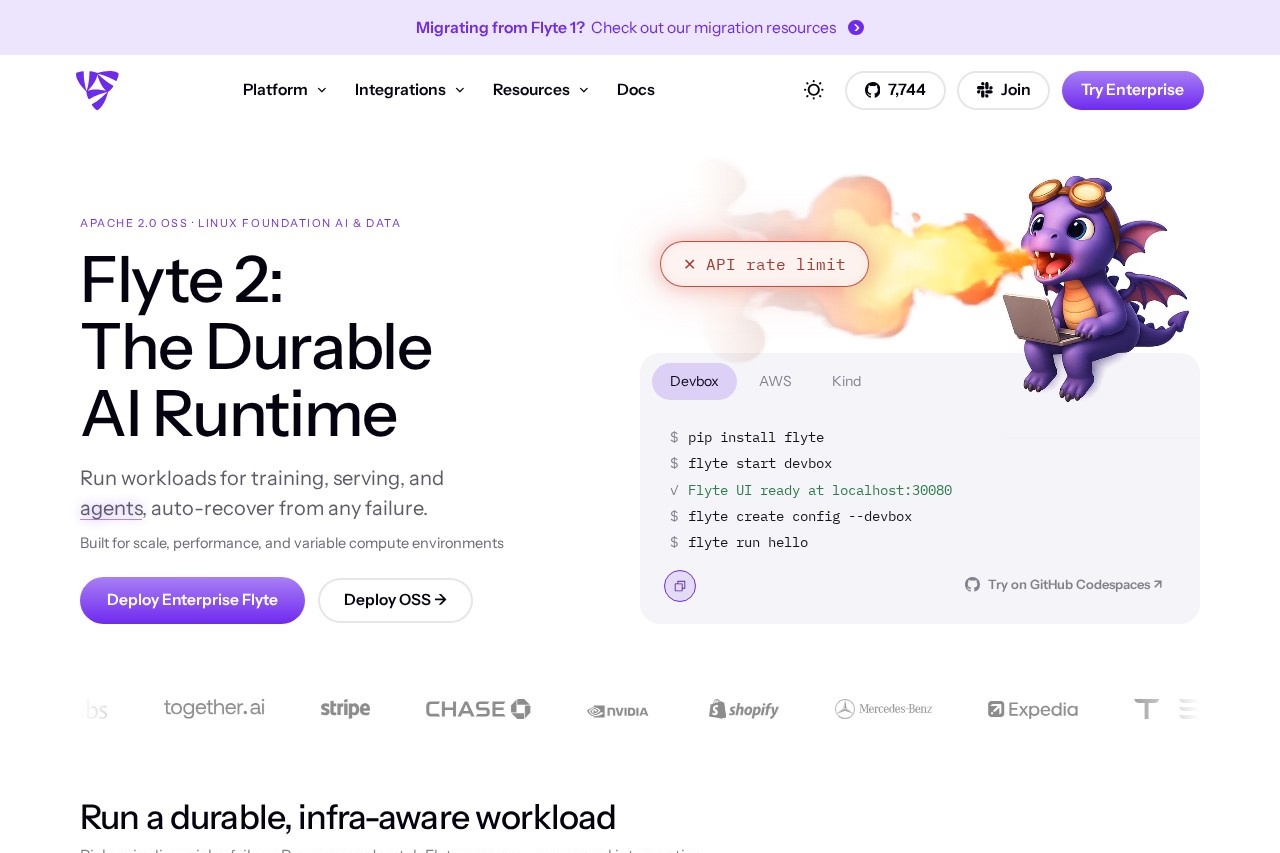
Flyte é um runtime open source para construir e executar workloads de IA — inferência em lote, fine-tuning, pré-treinamento, aprendizado por reforço e loops de agentes — com recuperação automática tanto de falhas de infraestrutura quanto de erros de código. Ele resolve uma dor comum em pipelines de machine learning: quando uma etapa falha, todo o job geralmente precisa ser reexecutado, desperdiçando computação e tempo. O Flyte registra entradas e saídas de cada etapa, de modo que a execução retoma da tarefa que falhou em vez de reiniciar o pipeline inteiro.
O projeto é licenciado sob Apache 2.0 e governado pela iniciativa Linux Foundation AI & Data. Desenvolvedores definem workflows como código comum usando SDKs nativos de linguagem (Python, TypeScript, Rust, Go e Mojo), com um construto TaskEnvironment que declara imagens, recursos, secrets e política de retry. O mesmo código pode rodar localmente, em um ambiente de desenvolvimento ou em um cluster de produção. A Union.ai oferece uma distribuição empresarial gerenciada do Flyte para times que desejam uma plataforma hospedada.
Principais Recursos
- Execução durável com recuperação automática: O Flyte reenvia tarefas após OOM kills, nós spot preemptados, desaparecimento de GPUs e interrupções de nós, às vezes com configurações de recursos corrigidas, sem intervenção manual.
- Retries com consciência de falhas e retomada: Falhas lógicas como exceções de código ou limites de taxa de API acionam retries com exatamente as mesmas entradas, e shards já concluídos de um job nunca são reexecutados.
- Workflows em código simples com múltiplos SDKs: Desenvolvedores escrevem tarefas como funções async comuns em Python, TypeScript, Rust, Go ou Mojo, usando fluxo de controle padrão para ramificação, loops e fan-out — sem DSL ou YAML separados.
- Endpoints em tempo real e dashboards: A mesma API Python pode servir aplicações de longa duração, com integrações nativas para Streamlit, FastAPI, vLLM, SGLang e Ollama, incluindo endpoints de LLM compatíveis com OpenAI, com streaming de modelos e paralelismo de tensores.
- Amplas integrações com o ecossistema: As integrações oficiais cobrem Apache Spark, Ray, PyTorch Elastic, BigQuery, Snowflake, Weights & Biases, MLflow, Dask, Databricks e frameworks de agentes como OpenAI Agents SDK, LangGraph, CrewAI e Pydantic AI.
- Autoscaling e scale-to-zero: A infraestrutura escala para cima e para baixo conforme a demanda do workload, e réplicas ou scaledown para aplicações servidas podem ser configurados com uma única linha.
- UI de produção e ferramentas para agentes: Uma UI construída para execuções em produção suporta depuração, e o código de agentes pode ser isolado em sandbox com cada chamada de LLM rastreada.
Destaques
- Preços: O Flyte em si é gratuito e open source sob a licença Apache 2.0; os planos empresariais via Union.ai não são publicamente listados nas páginas que analisamos, então consulte o site oficial para os termos atuais.
- Licença e governança: Licenciado sob Apache 2.0, com governança aberta sob Linux Foundation AI & Data.
- Ambientes interativos: O Flyte Devbox e uma opção de GitHub Codespaces permitem que desenvolvedores experimentem a plataforma rapidamente, com suporte a harness para ferramentas como Claude Code, Codex CLI e OpenCode.
- Usuários de produção documentados: Estudos de caso no site oficial descrevem uso na Spotify (pipelines de previsão financeira), Wayve (workloads de visão em escala de petabytes para P&D de direção autônoma) e Cradle (pipelines de ML para design de proteínas).
- Suporte à migração: Existem recursos dedicados de migração para times que estão migrando do Flyte 1 para o Flyte 2.
Para Quem É
O Flyte é voltado para engenheiros de machine learning, times de plataforma e pesquisadores que executam treinamento, inferência em lote ou workloads de agentes em computação variável ou spot e precisam de pipelines que sobrevivam a falhas. Casos de uso típicos incluem jobs de fine-tuning e pré-treinamento, treinamento distribuído com Ray ou PyTorch, consultas a data warehouses como BigQuery ou Snowflake, e serving de endpoints de LLM com vLLM ou SGLang. Ele atende organizações que desejam pipelines reproduzíveis, retomáveis e com observabilidade nos estágios de experimento e de produção, bem como times construindo sistemas de agentes que exigem rastreamento de cada chamada de LLM.




