Introdução
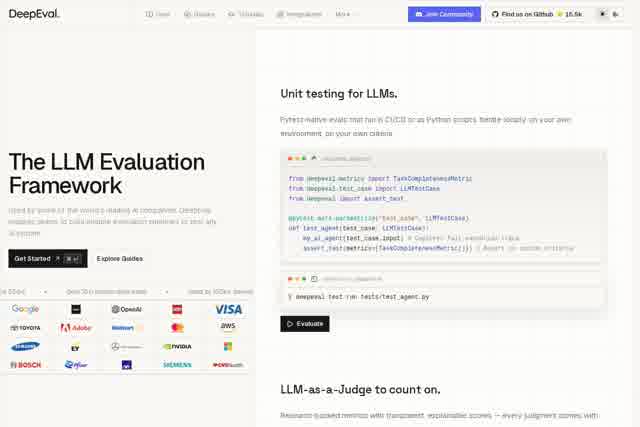
No desenvolvimento moderno de aplicações de IA, avaliar e testar grandes modelos de linguagem tornou-se um fator crítico para o sucesso de um projeto. O DeepEval, da Confident AI, é um framework open-source de avaliação de LLMs projetado especificamente para testar e fazer benchmarking de aplicações baseadas em LLMs. Se você está construindo agentes de IA, sistemas RAG, chatbots ou outras aplicações baseadas em modelos de linguagem, o DeepEval oferece mais de 50 métricas de avaliação plug-and-play para ajudar equipes de desenvolvimento a medir de forma rápida e confiável a qualidade, a precisão e a segurança das saídas dos modelos. Como uma ferramenta leve, porém poderosa, o DeepEval tem como missão tornar a avaliação de LLMs tão simples, repetível e integrável quanto testes unitários.
Principais Recursos
- Mais de 50 métricas de avaliação prontas para uso: abrangem precisão, relevância, fidelidade, detecção de alucinações, recall de contexto, filtragem de toxicidade e mais, cobrindo os principais cenários, incluindo RAG, agentes, sumarização e conversação.
- Framework de testes integrado: permite escrever casos de avaliação em Python e se integra perfeitamente a pipelines de CI/CD existentes para testes de regressão automatizados.
- Suporte a múltiplos modelos e múltiplos datasets: avalie diferentes LLMs ou diferentes versões do mesmo modelo simultaneamente, facilitando comparações lado a lado e a otimização iterativa.
- Pipelines de avaliação personalizáveis: combine múltiplas métricas, defina pesos de pontuação e limites personalizados para atender a requisitos específicos do negócio.
- Dashboard visual (plataforma Confident AI): oferece colaboração em nuvem e visualização de resultados, permitindo que as equipes compartilhem relatórios de avaliação e registros históricos.
Destaques
- Preços: Não listado publicamente nas páginas que analisamos; consulte o site oficial para conhecer os planos atuais.
- Framework open-source: O DeepEval é um projeto open-source com código publicamente disponível, então o framework principal pode ser usado sem custo.
- Avaliação auto-hospedada: Roda localmente com uma opção de armazenamento local no backend, dando às equipes controle sobre onde os dados e resultados de avaliação ficam guardados.
- Integração com CI/CD: Os scripts de avaliação seguem o estilo de testes unitários do pytest e podem ser executados em pipelines de CI/CD para testes de regressão contínuos.
Para Quem É
O DeepEval foi criado para todos os profissionais envolvidos no desenvolvimento e operação de aplicações de LLM, incluindo, mas não se limitando a: desenvolvedores de aplicações de IA que precisam validar continuamente a qualidade das saídas dos modelos durante o desenvolvimento para garantir a correção funcional; engenheiros de machine learning e cientistas de dados que desejam comparar sistematicamente o desempenho de diferentes modelos, prompts ou estratégias de recuperação; engenheiros de QA e testes que buscam soluções de avaliação automatizada para incorporar testes de comportamento de LLMs em fluxos de teste padrão; e gerentes de produto e líderes técnicos que precisam de métricas objetivas para orientar decisões de iteração de produto e monitorar o desempenho dos modelos após a implantação.