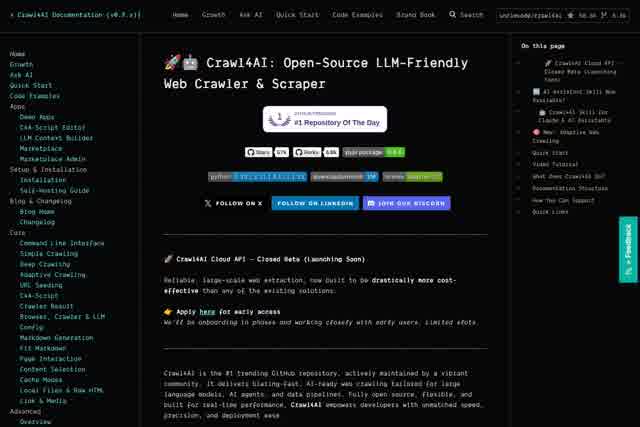
Introdução
Crawl4AI é uma ferramenta open-source de web crawling e extração de dados criada especificamente para aplicações de grandes modelos de linguagem (LLMs). Ele resolve os problemas comuns das ferramentas tradicionais de scraping, como limpeza de dados ineficiente, saída não estruturada e baixa compatibilidade com pipelines de IA. Com um design de API limpo e um motor de parsing poderoso, o Crawl4AI transforma rapidamente qualquer página web em texto limpo ou dados estruturados que os LLMs podem consumir diretamente. Ele ajuda desenvolvedores, cientistas de dados e pesquisadores de IA a melhorar drasticamente a velocidade e a qualidade da aquisição e do pré-processamento de dados.
Principais Recursos
- Extração inteligente de conteúdo: identifica e remove automaticamente anúncios, barras de navegação, rodapés e outros elementos irrelevantes para extrair com precisão o conteúdo principal, como texto de artigos, títulos e listas.
- Saída em múltiplos formatos: suporta texto simples, Markdown, JSON e fragmentos HTML, integrando-se perfeitamente aos requisitos de entrada de diferentes LLMs.
- Crawling de páginas dinâmicas: suporte nativo a navegador headless para renderizar conteúdo gerado por JavaScript, cobrindo aplicações de página única (SPAs) e páginas interativas complexas.
- Processamento em lote e agendamento: suporta crawling concorrente de múltiplas URLs, intervalos personalizados entre requisições, mecanismos de retry e atualizações incrementais para coleta de dados em larga escala.
- Pré-processamento otimizado para LLMs: oferece tokenização, sumarização e chunking semântico para gerar diretamente segmentos de corpus adequados para embeddings ou fine-tuning.
Destaques
- Preços: planos de API hospedada a partir de $10/mês (Starter: 10.000 créditos, 120 requisições/minuto, 10 concorrentes), com Builder a $99 e Scale a $499 por mês; a versão open-source self-hosted é gratuita.
- Plano gratuito: uma chave de API gratuita inclui 1.000 créditos por mês, com 10 requisições por minuto e 2 requisições concorrentes.
- Créditos: créditos extras adquiridos em planos pagos nunca expiram; uma tabela de preços em tempo real está disponível pelo endpoint /v1/prices.
- Licença: o crawler open-source é licenciado sob Apache-2.0 (versões mais antigas sob MIT), sem restrições comerciais.
- Acesso à API: uma única chave funciona em todos os endpoints /scrape, /extract, /search, /serp e /answer, além de integração MCP com Claude Code, Codex, Cursor e outros agentes, com servidores nas regiões da UE, Cingapura e EUA.
Para Quem É
O Crawl4AI é especialmente adequado para desenvolvedores de IA e LLMs que precisam de grandes volumes de dados web limpos e estruturados para treinamento de modelos, fine-tuning ou construção de bases de conhecimento. Também atende cientistas de dados e analistas que desejam agregar rapidamente informações de vários sites para análise de tendências ou pesquisa competitiva, bem como pesquisadores que extraem dados textuais de sites acadêmicos, portais de notícias ou redes sociais. Além disso, engenheiros de automação e equipes de operações de conteúdo podem usá-lo para monitorar atualizações de páginas, coletar informações de produtos ou agregar notícias do setor de forma recorrente.