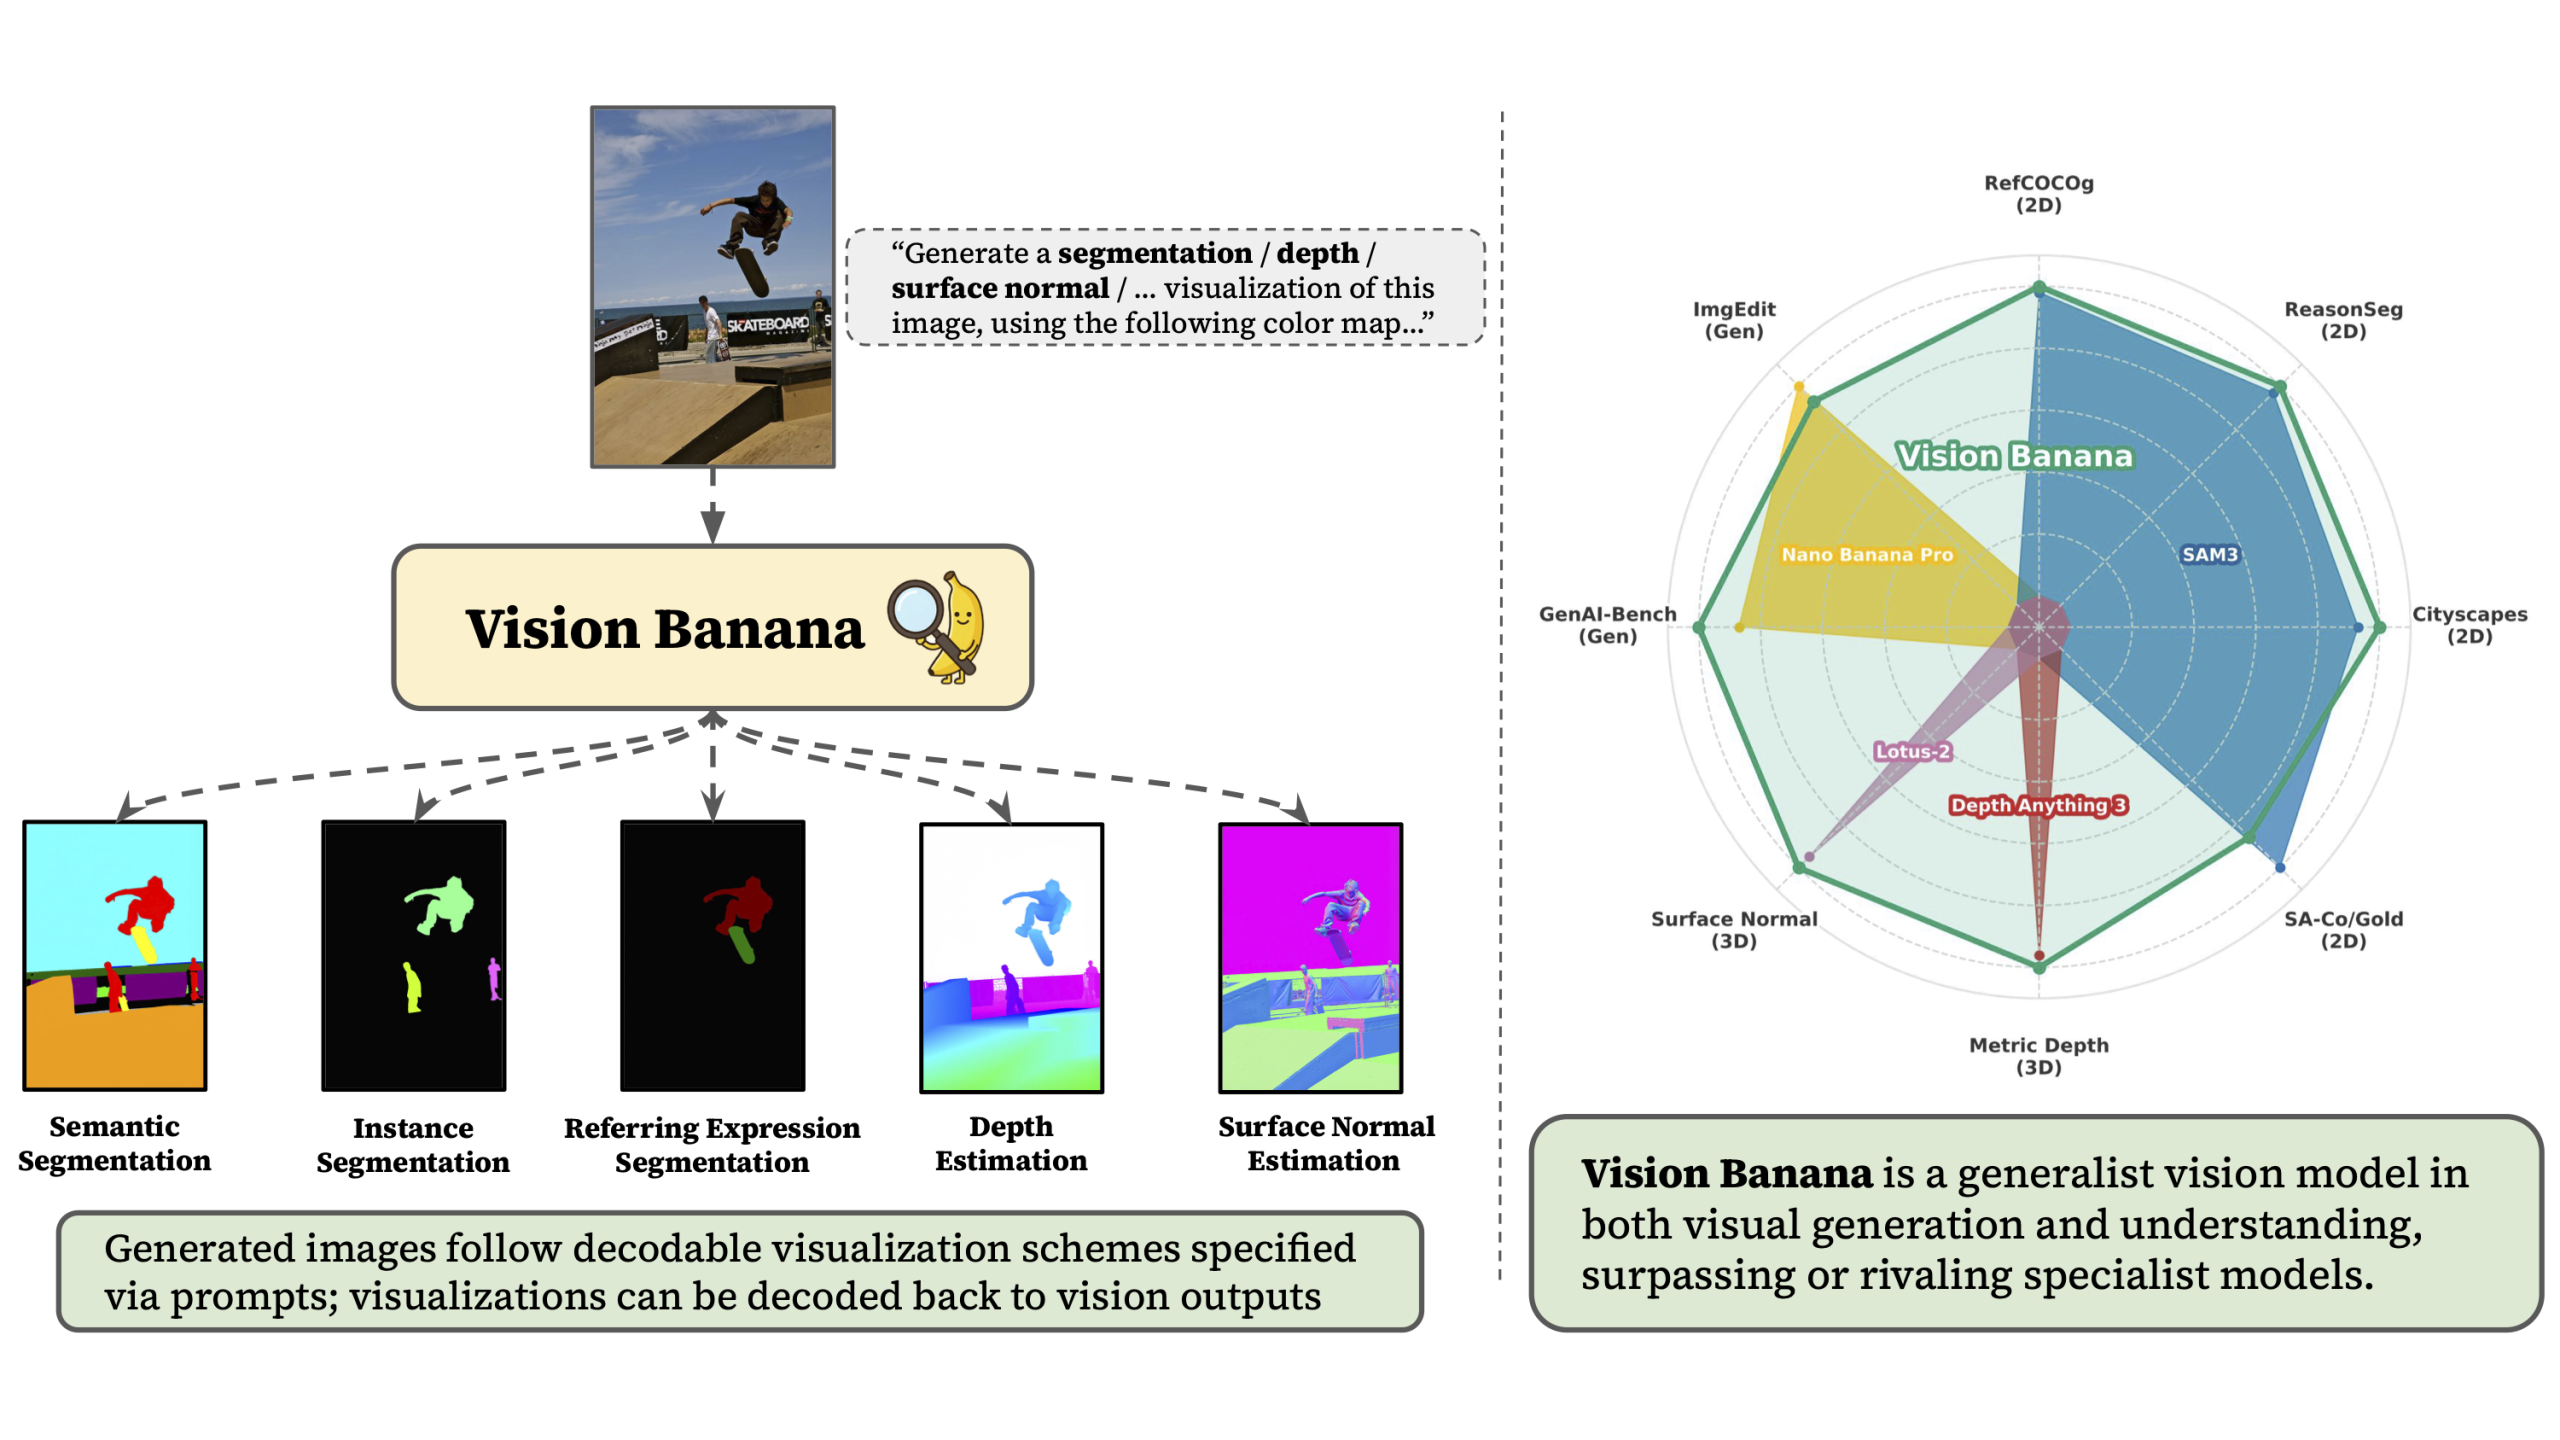
长期以来,计算机视觉领域一直分为两条独立的发展轨道:生成模型(负责创作图像)和判别模型(负责理解图像)。行业普遍的假设是——擅长画画的模型不一定擅长读图。但 Google DeepMind 的最新研究彻底颠覆了这一认知。
2026 年 4 月 22 日,Google DeepMind 团队发布了题为《Image Generators are Generalist Vision Learners》(图像生成器是通用视觉学习者)的论文,正式推出 Vision Banana——一个统一的通用视觉模型,在语义分割、实例分割、单目度量深度估计和表面法线估计等多项视觉理解任务上,超越了或持平于最先进的专业系统,同时保留了原始图像生成能力。
🍌 核心理念:从 LLM 类比到视觉世界
如果你了解大语言模型(LLM),你一定熟悉两阶段训练范式:首先在海量文本数据上进行生成式预训练,然后进行指令微调以适配下游任务。预训练阶段让模型发展出丰富的内部语言表示,可以重新用于几乎任何任务。
Google 团队的核心观点是:图像生成训练在视觉领域扮演着与 LLM 预训练完全相同的角色。 其基础模型 Nano Banana Pro (NBP) 是 Google 最先进的图像生成器。通过轻量级的指令微调——在 NBP 的原始训练数据中混合极小比例的计算机视觉任务数据——他们创建了 Vision Banana。
关键洞察:生成逼真图像隐含地要求模型理解几何、语义、深度和物体关系。Vision Banana 学会将这种潜在知识以可测量的、可解码的格式表达出来。
更重要的是,指令微调数据中不包含任何评估基准的训练数据,确保所有结果都反映了真正的通用能力,而非领域内记忆。
🔬 工作原理:将视觉感知转化为图像生成
Vision Banana 不添加任何专门的解码器头或回归模块,而是将所有视觉任务输出参数化为 RGB 图像。模型通过指令微调,产生遵循精确、可逆颜色方案的可视化输出——这意味着生成的图像可以解码回定量输出,用于基准评估。
研究团队识别了这种策略的三个关键优势:
- 统一模型:支持多种任务,指令微调后仅改变提示词,不改变权重
- 数据高效:需要的新训练数据相对较少,因为指令微调仅教会模型如何将计算机视觉输出格式化为 RGB
- 保留生成能力:模型保留了原始的图像生成能力,因为输出只是新的 RGB 图像
📊 具体任务实现
语义分割
模型接收类似指令:"生成此图像的分割可视化,使用颜色映射:{'cat': 'red', 'background': 'yellow'}"。每个像素按其预测类别着色,由于颜色分配在提示中指定,不需要固定的标签词汇表。
实例分割
由于实例数量未知,Vision Banana 使用逐类推理策略——每个类别单独运行一次,动态为每个实例分配唯一颜色。通过聚类相似颜色像素来恢复掩码。
度量深度估计
使用双射映射,将无界度量深度值 [0, ∞) 映射到有界 RGB 值 [0, 1]³。幂变换(形状参数 λ = -3,比例参数 c = 10/3)首先"弯曲"度量深度值,然后编码为伪彩色可视化,遍历 RGB 立方体的边缘,遵循 3D 希尔伯特曲线的结构。此变换严格可逆,生成的深度图像可干净地解码回物理度量距离。
关键的是,训练和推理时都不需要任何相机参数——既不依赖内参也不依赖外参。模型仅从视觉线索和预训练期间嵌入的世界知识推断绝对尺度。深度训练数据完全来自合成数据,由模拟渲染引擎生成,零真实世界深度数据。
表面法线估计
映射更加直接:表面法线是单位向量 (x, y, z),范围从 -1.0 到 1.0,自然映射到 RGB 通道。朝左的法线编码为粉红色;朝上的法线编码为浅绿色;指向相机的法线编码为浅蓝色/紫色。
🏆 超越专家:用数据说话
Vision Banana 在多个基准测试中的表现(全部为零样本迁移设置,模型从未见过评估数据集中的任何训练数据)令人瞩目:
2D 语义理解
- 语义分割(Cityscapes val):mIoU 0.699,对比 SAM 3 的 0.652——领先 4.7 个百分点
- 指代表达分割(RefCOCOg UMD val):cIoU 0.738,略胜 SAM 3 Agent 的 0.734
- 推理分割(ReasonSeg val):gIoU 0.793,击败 SAM 3 Agent 的 0.770——甚至超越了使用领域内数据训练的非零样本方法
- 实例分割(SA-Co/Gold):pmF1 0.540,与 DINO-X(0.552)相当,领先 Gemini 2.5(0.461)、APE-D(0.369)和 OWLv2(0.420)
3D 结构理解
- 度量深度估计:在六个主要基准上的平均 δ1 为 0.882;在 Depth Anything V3 评估的四个数据集(NYU、ETH3D、DIODE-Indoor、KITTI)上,Vision Banana 得分 0.929,对比 Depth Anything V3 的 0.918——且使用零真实世界训练数据和零相机参数
- 表面法线估计:四个数据集上的平均平均角度误差为 18.928°,对比 Lotus-2 的 19.642°。在室内数据集上,Vision Banana 实现了所有对比方法中最低的平均角度误差(15.549°)和中值角度误差(9.300°)
生成能力保持
在生成基准上,Vision Banana 与其基础模型不相上下:在 GenAI-Bench(文本到图像)上以 53.5% 的胜率击败 Nano Banana Pro,在 ImgEdit(图像编辑)上以 47.8% 的胜率竞争(Nano Banana Pro 为 52.2%)。总体而言,结果证实轻量级指令微调不会降低模型的生成能力。
💡 关键启示
1. 图像生成预训练是通用视觉学习者
正如 LLM 预训练解锁了涌现的语言理解能力,Google 的研究表明,在图像生成上进行训练自然发展出强大的内部视觉表示,可迁移到分割、深度估计和表面法线估计等感知任务。
2. 无需专家架构,超越专家模型
Vision Banana 通过对 Nano Banana Pro 进行轻量级指令微调构建,在三个分割基准上超越 SAM 3,在度量深度估计上超越 Depth Anything V3(δ1: 0.929 vs 0.918),在表面法线估计上超越 Lotus-2(平均角度误差:18.928° vs 19.642°)——全部在零样本迁移设置下实现。
3. 所有视觉任务被重构为图像生成
通过将视觉任务输出参数化为具有可解码颜色方案的 RGB 图像,Vision Banana 使用单一权重集和仅提示词切换,跨越语义分割、实例分割、深度估计和表面法线估计——不需要任务特定模块。
4. 无需相机参数或真实世界数据的度量深度估计
使用双射幂变换将深度值映射到 RGB 颜色空间,Vision Banana 仅从视觉上下文推断绝对度量尺度——既不需要相机内参也不需要外参,且完全使用模拟引擎的合成数据进行训练。
5. 图像生成可作为视觉的通用接口
类似于文本生成如何统一语言任务,图像生成可能成为计算机视觉的通用输出接口,指向一个范式转变:生成式视觉预训练为生成和理解构建基础视觉模型。
🔮 范式转变的信号
Vision Banana 的发布可能标志着计算机视觉领域的一次重大范式转变。正如文本生成在语言理解和推理中扮演的统一角色,图像生成可能成为视觉理解的通用接口。
研究团队指出,我们可能正在见证一个重大转变:生成式视觉预训练在为生成和理解构建基础视觉模型中发挥核心作用。这意味着未来我们可能不再需要为每个视觉任务训练专门的模型,而是通过指令微调一个统一的生成模型来完成所有任务。
这不仅是技术上的突破,更是对"生成与理解是否本质相关"这一长期哲学问题的有力回答——能够创造视觉内容的模型,必然也具备理解它的能力。
论文地址:arXiv:2604.20329